




Fleak
Fleak, outil intelligent axé sur la conception par IA
Étiquettes :Outils de conception IAUne phrase pour présenter
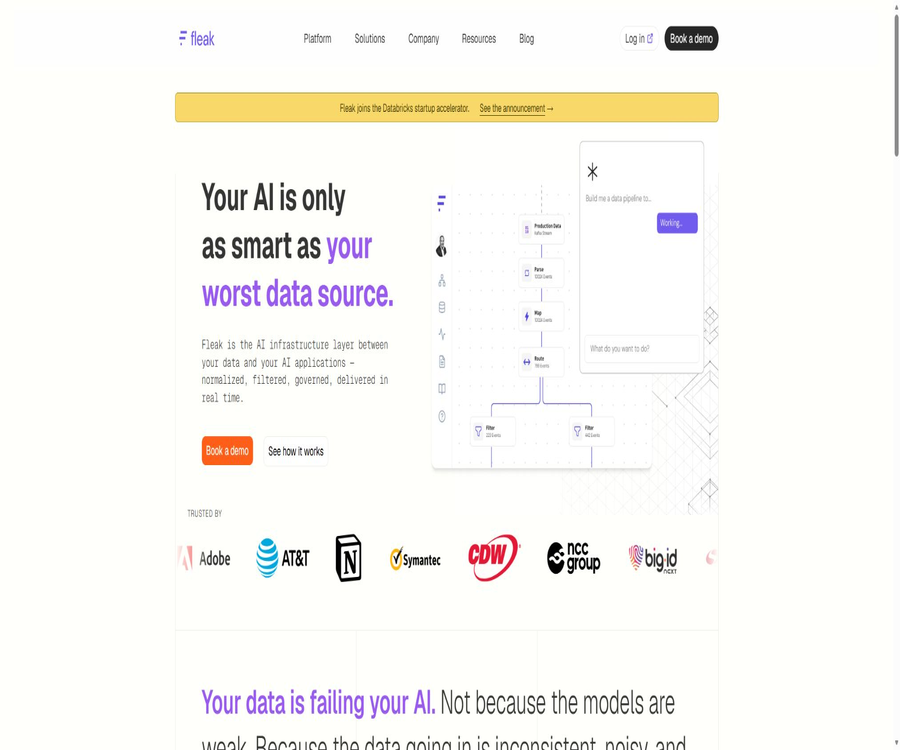
Fleek est une infrastructure de données en temps réel destinée à l’IA d’entreprise, aux données machines et à l’analyse par flux, qui permet d’effectuer la transformation, la normalisation, le filtrage, la suppression des doublons, la gouvernance et le routage selon la valeur entre les sources de données et les applications d’IA.
Présentation des outils
Fleak a été développé par Fleak Tech Inc. et est conçu comme une couche de données native pour l’IA, et non comme un chatbot universel. Les utilisateurs créent des flux de données à l’aide d’un DAG visuel ou en langage naturel, puis les déploient sur des clusters de calcul hébergés pour un traitement asynchrone distribué.
La plateforme résout principalement les problèmes de formats de données incohérents, de changements de schéma en amont, d’événements répétitifs, d’occupation de stockage et de tokens par des données sans valeur, ainsi que les incohérences de droits d’accès entre les différents systèmes en aval. ZephFlow est quant à lui un moteur de traitement sans état, open source et pouvant être utilisé indépendamment.
Composition du produit
| Composition | Rôle principal | Mode de fonctionnement | État ouvert |
|---|---|---|---|
| Plateforme d’hébergement Fleak | Connecter, orchestrer, déployer, surveiller et gérer les pipelines de données | Cluster de calcul en gestion déléguée | Services commerciaux, réservation de démonstration |
| Workflow Builder | Configurer les canaux, les nœuds de traitement et les sorties avec DAG | Interface web | Le document est public, les capacités du compte selon le plan |
| AI Copilot | Configuration du pipeline de génération de langage naturel et assistance aux modifications de schéma | Utilisation sur la plateforme | Fonction commerciale |
| ZephFlow Core | Traitement de données en flux sans état | Applications intégrées, processus indépendants ou services réseau | Open source Apache 2.0 |
| ZephFlow Python SDK | Combiner le filtrage, la transformation et la gestion des erreurs en Python | Python appelle le moteur Java 17 | Open source Apache 2.0 |
Principe de fonctionnement
- Accéder aux événements bruts depuis Kafka, Splunk, les journaux des machines, les bases de données, les systèmes industriels ou d’autres sources.
- Identifier les types d’événements, la signification des champs, le schéma et les besoins des applications cibles à l’aide de l’IA ou de règles.
- Utiliser l’analyse, le filtrage, les assertions, les expressions ou les nœuds SQL pour nettoyer, valider, normaliser et prendre des décisions conditionnelles.
- Diriger les enregistrements vers des destinations différentes en fonction de la valeur en temps réel, de la valeur de conformité et du schéma cible.
- Traitement continu après déploiement dans un cluster de calcul hébergé, avec surveillance du débit, des erreurs et de la santé du pipeline sur le panneau de contrôle.
- Lors de la détection d’un dérive du schéma en amont, une nouvelle configuration est générée, qui est ensuite révisée par l’équipe avant déploiement.
Fonction principale
Route de perception de la valeur de l’IA
Fleak évalue la valeur de chaque donnée d’entrée pour les applications d’IA ou métier en aval, avant de décider s’il convient de la transmettre en temps réel, de la conserver à long terme ou de la jeter. Cela permet de réduire les événements inutiles, redondants et de faible valeur avant qu’ils n’arrivent dans un data lake, un SIEM ou un modèle.
Mise en page du langage naturel
L’utilisateur peut décrire l’objectif en langage naturel, et Copilot génère la configuration de traitement des données. Les résultats générés doivent néanmoins être vérifiés à l’aide d’échantillons d’événements réels pour les champs, les conditions limites et le traitement des erreurs ; la description ne peut pas être directement utilisée comme règle de production.
Dérive du schéma d’autoguérison
La plateforme peut détecter les changements dans le schéma en amont, envoyer des alertes et générer de nouvelles configurations. Le site officiel dispose d’une page mentionnant le redéploiement automatique, ainsi que de directives exigeant l’approbation de l’utilisateur avant déploiement ; l’environnement de production doit être configuré selon le principe de « détection et génération automatiques, puis publication après vérification manuelle ».
Visualisation des workflows DAG
Workflow Builder relie les canaux, les nœuds de traitement et les nœuds de sortie en un graphe orienté sans boucles, où la sortie de chaque nœud en amont devient l’entrée du nœud suivant. Avant la publication, la plateforme vérifie le DAG, puis le cluster hébergé s’occupe de la parallélisation, de la concurrence et de la charge.
Analyse multi-format
Les nœuds de parsing peuvent traiter des textes structurés ou semi-structurés tels que JSON, paires clé-valeur, CSV, Grok, Syslog, CEF et plusieurs lignes sous Windows. Les champs obtenus après le parsing peuvent ensuite être utilisés pour le filtrage, les assertions, SQL et la mise en correspondance avec des schémas.
Filtrage, assertions et expressions
Le filtre sert à exclure les enregistrements indésirables, l’assertion est utilisée pour vérifier les champs obligatoires et la qualité des données, tandis que Fleak Eval est chargé de créer ou de modifier les champs. Les enregistrements échoués peuvent être envoyés dans le suivi des erreurs ou dans une file de messages morts.
Transformation de données SQL
FleakSQL permet aux équipes familières avec SQL de transformer des enregistrements, réduisant ainsi le coût d’apprentissage d’expressions spécifiques. Sa compatibilité ne couvre pas tous les dialectes de bases de données ; avant de migrer des requêtes complexes, il est nécessaire de consulter la documentation syntaxique et de réaliser des tests de compatibilité.
Suppression des doublons et normalisation
La plateforme filtre, élimine les doublons et unifie le schéma avant que les données ne soient stockées ou utilisées dans les modèles, ce qui permet de réduire les contenus redondants dans le stockage, les requêtes et le contexte des modèles. Les baisses de coûts indiquées sur le site officiel sont des indicateurs publicitaires ; les résultats réels dépendent de la qualité des données et des règles appliquées.
Gouvernance et audit à faible granularité
Fleak met en œuvre un contrôle d’accès au niveau des données et enregistre les processus de transformation et de livraison ; le site officiel indique un historique d’audit complet ainsi que la certification SOC 2 Type II. Les entreprises doivent demander les rapports les plus récents, la portée, les exceptions et les accords de traitement des données lors de leurs achats.
Exécution asynchrone distribuée
Une fois le flux de travail géré déployé, il s’exécute sur le cluster de calcul Fleak ; la plateforme gère automatiquement la parallélisation, la concurrence et l’extension des ressources. L’équipe n’a pas besoin d’écrire elle-même la logique de multithreading et d’équilibrage de charge, mais doit tout de même définir des objectifs en matière de capacité, de latence et de fiabilité.
Observabilité
Le panneau de surveillance sert à examiner l’état des canaux, le débit et les erreurs, afin de détecter les interruptions de canal, les échecs de traitement ou les problèmes de destination. Avant la mise en production, il convient de confirmer la durée de conservation des indicateurs, les canaux d’alerte, les champs de journalisation et les niveaux de service.
Transmission en temps réel sans stockage
Le site officiel souligne que les données peuvent être converties en temps réel et envoyées directement au système cible, sans avoir à être stockées sur le long terme dans Fleak. Zéro stockage est une capacité de conception du pipeline, ce qui ne signifie pas que les journaux, les audits, les erreurs ou les métadonnées opérationnelles ne sont pas du tout conservés.
Nœuds publics et format de données
| Catégorie | Nœuds ou formats clairement rendus publics | Utilisation principale | Rappel de vérification |
|---|---|---|---|
| canal | Source Kafka, Source Splunk | Thèmes en flux et entrée de requêtes Splunk | Les canaux indiqués sur le site officiel ne signifient pas que chaque connecteur dispose de documents publics. |
| traitement | Évaluation de fuites, Filtrage, Assertion, Analyseur, SQL | Conversion, filtrage, validation, analyse et traitement par requête | Les expressions ont leur propre gamme de syntaxe spécifique à SQL. |
| Format d’analyse | JSON, clé-valeur, CSV, Grok, Syslog, CEF, plusieurs lignes sous Windows | Transformer le texte original en enregistrement structuré | L’échantillon doit couvrir les anomalies et les limites à plusieurs lignes. |
| Sortie | Kafka, Delta Lake, Databricks, Elasticsearch | Messages, entrepôts de données et index de recherche | La vitesse de mise à jour peut varier d’un document à l’autre |
| Gestion des erreurs | File d’attente des messages morts S3 | Enregistrer les événements d’échec de capture, d’analyse, d’affirmation et de conversion | La documentation du SDK Python offre un soutien explicite |
| Schéma du secteur | Schemas de sécurité OCSF, UDM, CSF, etc. | Normalisation du journal de sécurité | La précision de la mise en correspondance doit être vérifiée avec l’outil cible. |
Créer un pipeline de données géré
- Réservez une démonstration et préparez le type d’entrée, les événements de exemple, le débit maximal, le retard, le schéma cible et la destination.
- Créer un DAG dans Workflow Builder, configurer les connecteurs d’entrée ainsi que les droits de lecture strictement nécessaires.
- Ajoutez des nœuds Parser, Filter, Assertion, Eval ou SQL pour prévisualiser progressivement la sortie à chaque étape.
- Définir la destination pour le support Kafka, Delta Lake, Databricks, Elasticsearch ou contrats.
- Utiliser des données de test pour valider les cas normaux, ceux avec des champs manquants, les changements de type, les doublons, les enregistrements trop volumineux et les interruptions ciblées.
- Déployer dans un cluster hébergé, configurer la surveillance et les alertes, puis étendre progressivement grâce à un trafic contrôlé.
Gérer le dérive de schéma
- Définir des schémas attendus, des champs obligatoires, des types, des énumérations et des bases de données d’échantillons pour les canaux clés.
- Activer la détection des dérives et les alertes, afin de distinguer les champs ajoutés, les champs supprimés, les changements de type et les modifications des structures imbriquées.
- Vérifiez les nouvelles configurations et les mappages de champs générés par l’IA pour détecter d’éventuelles perte de données, conversion erronée ou élargissement inapproprié de l’accès aux données.
- Rejouer des événements anciens et nouveaux sur des données isolées pour comparer le taux de réussite, le schéma de sortie et la compatibilité descendante.
- Redéployer après l’approbation des modifications, tout en conservant la configuration précédente, les méthodes de rollback et les enregistrements d’audit.
Introduction à ZephFlow en Python
- Préparez Python 3.8 ou une version ultérieure ainsi que Java 17 ou une version ultérieure, car le SDK Python dépend du moteur de traitement Java.
- Installez le paquet zephflow, créez un flux minimal localement et validez l’environnement avec des événements en mémoire.
- Utiliser JSONPath pour filtrer les enregistrements, puis des expressions Eval pour créer des champs ou modifier la structure.
- Ajoutez une assertion et activez les résultats d’erreur étape par étape, afin de garantir que les données défectueuses ne parviennent pas silencieusement vers les processus ultérieurs.
- Configurez un profil ou une source Kafka pour les canaux continus, et configurez une file de messages morts S3 en cas d’erreur de production.
- Enregistrer le DAG qui a passé les tests au format YAML, et exécuter des tests d’échantillonnage et de régression dans l’intégration continue.
Processus de validation de la production
- Collecter des échantillons d’événements représentant des schémas normaux, anormaux, répétitifs, désordonnés, retardés et futurs.
- Définir pour chaque nœud de traitement les conditions d’acceptation en entrée, en sortie, en cas d’erreur et en termes de performance.
- Exécuter en parallèle l’ancien pipeline et Fleak, puis comparer le nombre d’enregistrements, les champs, les délais et les résultats de destination.
- Simuler la rupture du canal, l’expiration des identifiants, la limitation de débit cible, les fluctuations réseau et de nombreux événements d’erreur.
- Vérifier l’audit, le contrôle d’accès, les alertes, la réexécution des messages morts et le rollback, avant de décider de basculer le trafic en production.
À qui s’adresse-t-il
- Équipe d’ingénierie des données : accès rapide à de nouveaux canaux et réduction du travail répétitif de maintenance des schémas et des règles de transformation.
- Équipe de la plateforme d’IA : nettoyage, suppression des doublons et normalisation des entrées avant l’utilisation de RAG, d’agents et de modèles.
- Équipe de gestion de la sécurité : mapper les journaux hétérogènes vers un schéma de sécurité unifié, et filtrer le bruit entrant dans le SIEM.
- Équipe Industrie et IoT : unification des capteurs et de la télémétrie OT, réduction des lectures redondantes et des différences de balises.
- Équipe de fintech : standardisation des événements de transaction pour fournir des données cohérentes aux systèmes de fraude, de risque et de conformité.
- Développeurs Java et Python : exécuter des traitements sans état dans leurs propres applications à l’aide de ZephFlow sous Apache 2.0.
Scénarios d'utilisation typiques
- Normalisation du journal de sécurité : conversion des événements provenant de différents fabricants en OCSF, UDM ou CSF avant leur transmission au système de détection.
- Gestion des entrées d’IA : suppression des événements redondants et à faible valeur, unification des champs avant de les transmettre au modèle ou à l’agent.
- Ingestion depuis le lac de stockage : traitement des données à partir de Kafka ou Splunk et écriture dans Delta Lake ou Databricks.
- Index de recherche en temps réel : conversion en masse des événements et écriture dans Elasticsearch pour enquête et recherche.
- Nettoyage par télémétrie industrielle : unification des étiquettes, unités et schémas des équipements, filtrage des lectures bruitées.
- Préparation des données frauduleuses : normalisation des transactions multicanal, complément des règles et conservation d’un audit complet du traitement.
- Traitement de données embarquées : intégrer ZephFlow en tant que bibliothèque Java dans des services existants, sans utiliser de plateforme hébergée.
Avantages du produit
- Intégrer la connexion, l’analyse, la conversion, la gouvernance et la livraison dans un pipeline en temps réel pour réduire les systèmes intermédiaires.
- La configuration de génération de langage naturel abaisse la barrière à l’entrée, tout en conservant des nœuds DAG pour que les ingénieurs puissent les vérifier.
- La détection du dérive de schéma et la génération de configurations peuvent réduire le temps de correction après des modifications en amont.
- Les clusters gérés gèrent le traitement en parallèle, en concurrence et l’escalabilité, ce qui convient aux équipes qui ne souhaitent pas gérer elles-mêmes l’infrastructure de traitement des flux.
- Le routage par perception de valeur filtre les données avant qu’elles n’entrent dans le stockage et le modèle, ce qui permet de contrôler l’utilisation du stockage et des tokens.
- Le noyau Java de ZephFlow et le SDK Python utilisent Apache 2.0, ce qui facilite la validation locale et le développement secondaire.
- Les affirmations, le suivi des erreurs et la file de messages morts S3 offrent un chemin d’isolement clair pour les données défectueuses.
Restrictions d'utilisation et précautions
- Le site officiel ne divulgue pas de forfaits fixes, de crédits gratuits ni de prix unitaires précis ; les achats nécessitent une démonstration sur rendez-vous et une offre commerciale de l’entreprise.
- La connexion à n’importe quel canal relève d’une description de produit large ; les documents de flux de travail publics ne listent que certains canaux et nœuds de sortie.
- L’autoguérison ne peut pas se dérouler entièrement sans surveillance ; les erreurs de mappage des schémas peuvent propager rapidement les problèmes à tous les éléments en aval.
- Les chiffres concernant les performances et les économies de coûts du site officiel relèvent des indicateurs du fabricant et doivent être vérifiés à l’aide de ses propres événements, de son débit et de ses coûts ultérieurs.
- Aucun stockage ne signifie pas aucune traitement de données ni aucun journal ; les règles de conservation des données pour l’audit, les erreurs, la surveillance et le support doivent être confirmées par contrat.
- La plateforme de gestion et ZephFlow open source ne sont pas la même solution ; le moteur open source ne comprend pas de console commerciale, d’orchestration IA ni de services de gestion.
- Le SDK Python nécessite le moteur Java 17 ; tant le déploiement, que les conteneurs et l’environnement local doivent respecter ces deux exigences de runtime.
- La file d’attente des messages morts S3 ne fonctionne que dans les processus pilotés par des canaux de données ; les appels en mémoire traitent les erreurs étape par étape en retournant des résultats.
- Les permissions de données à faible granularité et les exigences en matière d’audit doivent être correctement configurées, car une autorisation erronée peut encore envoyer des enregistrements sensibles vers des destinataires inappropriés.
- Les pages de confidentialité, des conditions générales et du EULA du site officiel sont accessibles, mais l’extraction d’informations en public est limitée ; l’entreprise doit demander le texte complet avant de signer.
Prix et modalités d’achat
Au 22 août 2026, le site officiel de Fleak ne présente pas de tableau de prix public vérifiable, de plan gratuit, de période d’essai ou de tarif par unité selon la consommation ; l’entrée principale consiste à réserver une démonstration de 30 minutes. Aucun prix historique provenant de tiers ne doit servir de base pour les achats actuels.
| Produit ou poste de coût | Prix public | Possibles méthodes de mesure | Vérifier avant achat |
|---|---|---|---|
| Plateforme d’hébergement Fleak | Cotation sur mesure | Tuyaux, débit, calcul ou contrat d’entreprise | Engagement minimum, nombre d’environnements, niveaux de support et de service |
| Canaux et connecteurs | Non divulgué | Connecteur ou volume de données | Frais de connecteur standard et d’accès sur mesure |
| Calcul en flux | Non divulgué | CPU, nombre d’événements ou temps d’exécution | Pic de charge, élargissement et facturation supplémentaire |
| Stockage et données de courrier indésirable | Non divulgué | Quantité conservée et durée | Coûts de stockage d’objets, de journalisation et de réenregistrement |
| Gouvernance d’entreprise | Non divulgué | Utilisateurs, rôles, audit et environnement | Connexion unique, export d’audit et résidence des données |
| Moteur open source ZephFlow | Code source gratuit | Coûts d’infrastructure propre | Opérations, support, ressources cloud et services dérivés |
Les informations sociales officielles ont mentionné une facturation quotidienne selon un tableau de bord par canal ou une CPU en flux, mais le site officiel ne présente pas les chiffres actuels ni les règles complètes. Lors de la signature du contrat, il convient de se référer au devis officiel, à la commande et aux modalités de règlement.
Plateformes de support et déploiement
| Plateforme ou méthode | État de support | Utilisation | Demande |
|---|---|---|---|
| Construteur de DAG pour pages web | Soutien | Concevoir, déployer et surveiller les workflows hébergés | Compte d’entreprise |
| Cluster de calcul en gestion déléguée | Soutien | Traitement de flux asynchrone distribué | Allouer des ressources selon le contrat |
| Java SDK | Soutien | Intégrer l’application ou exécuter ZephFlow de manière indépendante | Java 17 |
| Python SDK | Soutien | Construire et exécuter ZephFlow avec Python | Python 3.8 et ultérieurs ainsi que Java 17 et ultérieurs |
| Processus indépendant | Soutien | Exécuter des pipelines sans état dans un environnement propre | Surveillance et maintenance autonomes |
| Services Internet | Soutien | Exécuter le processus de traitement via une interface de service | Protéger automatiquement les points d’extrémité et la capacité |
| Conteneur ou environnement cloud | Déployable | Exécuter des moteurs open source et leurs dépendances | L’utilisateur gère les images, les clés et les mises à jour |
API, SDK et situation du logiciel open source
ZephFlow Core est un framework de traitement de données sans état pour Java 17, qui peut fonctionner en tant que bibliothèque, processus indépendant ou service réseau ; la version indiquée dans le README actuel est 0.4.1. Il prend en charge les nœuds combinés, les assertions, le traitement des erreurs et un déploiement flexible.
Le SDK Python ZephFlow peut être installé depuis le dépôt de paquets Python et prend en charge l’API en flux, le filtrage JSONPath, la conversion Eval, la fusion de flux, les assertions et la file de messages morts S3. Le noyau Java ainsi que le SDK Python sont tous deux licenciés sous la licence Apache 2.0.
| Projet | Langage ou interface | Licence | Relations avec les plateformes commerciales |
|---|---|---|---|
| ZephFlow Core | Java 17 | Apache 2.0 | Capacité de traitement sans état au niveau de Fleak, pouvant fonctionner de manière indépendante |
| Module SDK ZephFlow | Dépendances Java | Apache 2.0 | Accessible via Gradle ou Maven |
| ZephFlow Python SDK | Python 3.8 et versions ultérieures avec le moteur Java | Apache 2.0 | Encapsulation Python et API de pipelines locaux |
| ZephFlow Examples | Exemple Java | Apache 2.0 | Démonstration de l'utilisation du moteur open source |
| Plateforme d’hébergement Fleak | DAG de pages web, IA et clusters hébergés | Services commerciaux propriétaires | Pas de mise en œuvre complète sous licence open source simplement parce que le moteur principal l’est. |
Confidentialité, sécurité et gouvernance
Fleak peut traiter des journaux de sécurité, des transactions, de la télémétrie industrielle et des données d’IA, qui contiennent des informations sur les comptes, les équipements, le réseau, les employés ou les clients. Les entreprises doivent définir si les données sont sauvegardées, la durée de conservation des métadonnées, les accès autorisés, les sous-traitants, les régions concernées et les procédures de suppression.
Le site officiel indique SOC 2 Type II, un contrôle d’accès à faible granularité, des journaux de conversion complets et des traces d’audit, mais la page de catalogue ne peut pas remplacer le rapport d’audit. L’acheteur doit vérifier la périodicité des rapports, la portée du produit, les exceptions aux contrôles ainsi que les limites de responsabilité pour les déploiements open source et hébergés.
- Se connecter aux canaux et aux cibles avec un compte aux droits minimaux, en gérant séparément les droits de lecture, d’écriture et d’administration.
- Utilisez des échantillons démasqués dans l’environnement de test ; ne transmettez pas directement les journaux de sécurité en production à des configurations d’IA non auditées.
- Établir une classification des données et des destinations autorisées pour chaque branche, afin d’empêcher que des champs sensibles ne soient transférés vers des systèmes non pertinents.
- Enregistrer la génération de la configuration, l’approbation manuelle, le déploiement, le retrait et les modifications de droits, afin de créer une chaîne auditable.
- Vérifier si les journaux de surveillance, la file de messages non livrés et les paquets de support contiennent les événements originaux complets.
- Définir le chiffrement, le contrôle d’accès, la durée de conservation et le processus de suppression après rediffusion pour les données de lettres mortes.
- Renouveler régulièrement les identifiants de Kafka, Splunk, du stockage cloud et des bases de données, et surveiller les lectures anormales.
- Inclure dans le contrat et l’accord de traitement des données les engagements en matière d’absence de stockage, de résidence des données et de suppression.
Informations de base
| Projet | Contenu |
|---|---|
| Nom de l’outil | Fleak |
| Société de développement | Fleak Tech Inc. |
| Type d’outil | Couche de données natives d’IA, pipelines de données en temps réel et traitement de flux |
| Interface principale | DAG Workflow Builder |
| Moteur open source | ZephFlow |
| Utilisateurs principaux | Équipe d’ingénierie des données, plateformes d’IA, sécurité, Internet des objets industriels et finance |
| Modèle de prix | Tarifs sur mesure pour les entreprises ; le code source de ZephFlow est gratuit |
| Faut-il s’inscrire ? | La plateforme de gestion nécessite un compte entreprise. |
| Soutien en chinois | Aucune interface chinoise claire n’a été trouvée. |
| Déploiement géré | Soutien |
| Java SDK | Fourni, Java 17 |
| Python SDK | Nécessite Python 3.8 ou supérieur ainsi que Java 17. |
| Le produit est-il open source | La plateforme de gestion n’est pas open source ; les composants ZephFlow le sont. |
| Licence open source | Apache 2.0 |
| Date de vérification du prix | 22 août 2026 |
Indice de recommandation
Note de recommandation : 4,0 / 5. Fleak combine l’analyse en temps réel, la suppression des doublons, la normalisation, la gouvernance, le traitement du dérive de schéma et la livraison vers plusieurs destinations, offrant une valeur claire pour les journaux de sécurité, la télémétrie industrielle et les pipelines d’entrée d’IA.
Les principaux défauts sont l’opacité des prix commerciaux, un écart entre le catalogue public des connecteurs et les informations présentées sur le site officiel, ainsi que le besoin pour le vendeur de fournir des détails sur la confidentialité et les contrats. Le fait que ZephFlow soit open source abaisse les barrières à la validation technique, mais une plateforme d’entreprise nécessite toujours un POC complet.
Questions fréquentes
À quoi sert Fleak ?
Il se situe entre la source de données et l’IA, le data lake, le SIEM ou le système de recherche, et analyse, nettoie, élimine les doublons, normalise, gère et dirige les événements en temps réel.
Fleak est-il gratuit ?
La plateforme de gestion ne propose pas de forfaits gratuits ou de périodes d’essai en ligne ; il est nécessaire de prendre rendez-vous pour une démonstration et d’obtenir un devis sur mesure. Le noyau de ZephFlow et le SDK Python peuvent être utilisés gratuitement sous licence Apache 2.0.
Combien coûte Fleak ?
Le site officiel ne divulgue pas de chiffre fixe. Les informations publiques indiquent que la facturation pourrait dépendre de l’utilisation quotidienne du tableau de flux ou de la CPU en mode flux, mais les prix unitaires spécifiques, les engagements minimaux et les règles de dépassement doivent se référer à la proposition de prix.
Fleak peut-il vraiment réparer automatiquement les tuyaux ?
La plateforme peut détecter automatiquement les changements de schéma et générer une nouvelle configuration, mais le site officiel indique également que l’utilisateur doit approuver et redéployer. Les pipelines critiques ne doivent pas passer à côté des tests, de l’approbation et du retrait.
Quels canaux sont pris en charge ?
Les documents de flux de travail publics énumèrent clairement Kafka et Splunk, tandis que le site officiel présente une large gamme de canaux tels que la sécurité, l’industrie, les interfaces et les bases de données. Les connecteurs non listés dans les documents doivent être confirmés par des démonstrations et des tests.
Quels types de sortie sont pris en charge ?
Le document inclut explicitement des sorties telles que Kafka, Delta Lake, Databricks et Elasticsearch. Les versions spécifiques, l’authentification, le traitement par lots, les tentatives de réessai et la sémantique des transactions doivent être vérifiées selon le connecteur cible.
Peut-on gérer les journaux de sécurité ?
Oui, la plateforme vise à normaliser les différents journaux de sécurité en OCSF, UDM ou CSF, puis à filtrer et éliminer les doublons avant qu’ils n’arrivent dans un SIEM ou des outils de détection par IA.
Fleak conserve-t-il les données brutes ?
Le site officiel prend en charge une transmission en temps réel sans stockage, mais cela ne prouve pas que toutes les données de surveillance, d’audit, d’erreurs et de support ne soient pas conservées. Les entreprises doivent confirmer par contrat la conservation et la suppression de chaque type de données.
Qu’est-ce que ZephFlow ?
ZephFlow est le moteur de traitement de données sans état publié par Fleak, qui peut être intégré dans des applications Java, exécuté de manière indépendante ou déployé en tant que service, et prend en charge le filtrage, la transformation, les assertions et le traitement des erreurs.
Y a-t-il un SDK Python ?
Oui, le SDK Python prend en charge la composition en flux, le filtrage JSONPath, la conversion Eval, la fusion, les assertions et la file de messagerie morte S3. Une version Java 17 est également requise au moment de l’exécution.
Fleak est-il open source ?
On ne peut pas l’ qualifier de manière générale de logiciel open source. Le noyau Java de ZephFlow, le SDK Python et certains exemples utilisent Apache 2.0, mais la plateforme d’hébergement, l’orchestration AI et la console sont des services commerciaux propriétaires.
Qu’est-ce que le SOC 2 Type II couvre ?
Le site officiel indique SOC 2 Type II, mais la page d’accueil ne précise pas l’étendue et la période du rapport. L’entreprise doit demander le rapport le plus récent pour vérifier s’il couvre la plateforme de hébergement, les infrastructures associées ainsi que les flux de données nécessaires.
Est-il adapté pour remplacer les plateformes existantes de traitement en flux ?
C’est possible, mais il ne faut pas se baser uniquement sur la liste des fonctionnalités. Il convient de rejouer en parallèle des données réelles et de comparer le sens, le débit, le retard, la récupération des erreurs, les connecteurs et le coût total avant de décider de l’étendue du transfert.
Comment éviter les mappages erronés de champs par l’IA ?
Définir des assertions et un schéma cible pour les champs clés, réinitialiser la configuration de l’IA à l’aide d’échantillons historiques et anormaux, et conserver l’approbation manuelle, la vérification des différences et le retrait en un clic.
Résumé
Fleak s’attaque aux problèmes de qualité des données et de gouvernance en amont des systèmes d’IA, en assurant une plus grande cohérence des données entrant dans les modèles, les data lakes ou les outils de sécurité grâce à des DAG en temps réel, à la configuration de l’IA, au traitement du dérive de schéma et à l’acheminement des données selon leur valeur.
Avant une adoption officielle, il convient de valider les connecteurs, les délais, les erreurs et les coûts par des moyens fiables, et d’inclure dans le contrat des clauses relatives à l’absence de stockage, au séjour des données, à l’audit, aux niveaux de service et à la suppression. Les équipes ayant uniquement besoin d’un traitement local sans état peuvent commencer par ZephFlow sous licence Apache 2.0.
Outils similaires à Fleak

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164