




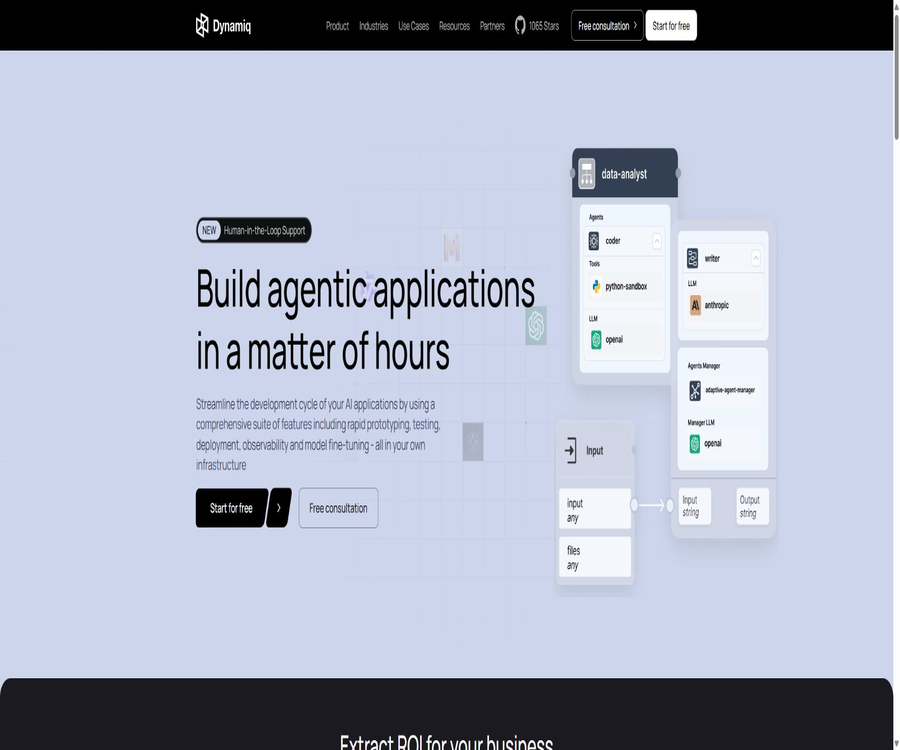
Dynamiq
Dynamiq, outil intelligent spécialisé dans la conception par IA
Étiquettes :Outils de conception IAUne phrase pour présenter
Dynamiq est une plateforme de développement et d’exploitation d’agents intelligents IA destinée aux développeurs et aux équipes d’entreprise, qui permet de créer des workflows, des applications RAG et des systèmes multi-agents à l’aide d’une toile de visualisation ou de frameworks Python open source, puis de les déployer en tant qu’applications appelables.
Présentation des outils
Dynamiq a été développé par Dynamiq Technologies ; ses produits couvrent la conception de prototypes, les tests, le déploiement, la surveillance, l’évaluation, la base de connaissances et le retouche de modèles. Il est adapté aux équipes techniques qui souhaitent faire passer leurs expérimentations avec l’IA générative en environnement de production.
Dynamiq comprend deux parties à distinguer : la plateforme commerciale offre un constructeur visuel, des capacités de mise en œuvre hébergée et de gestion d’entreprise ; quant au paquet dynamiq Python, il s’agit d’un framework d’orchestration open source sous licence Apache 2.0.
Composition du produit
| Composition | Positionnement | Mode de fonctionnement | Statut open source | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Plateforme Dynamiq | Plateforme de construction, de déploiement et d’exploitation d’agents intelligents | Dans le cloud ou hébergé en interne par l’entreprise | Logiciels commerciaux propriétaires | Équipe de produits, ingénierie de plateforme et clients entreprises |
| Framework Python | Agents, RAG et bibliothèques d’orchestration de workflows | Tout environnement compatible avec Python | Apache 2.0 | Développeurs ayant besoin de contrôle par code |
| REST API | Appeler l’application et gérer le fonctionnement, la base de connaissances et l’évaluation | Authentification via une clé d’accès ou un jeton personnel | L’interface de la plateforme ne signifie pas que la plateforme est open source. | Développeurs backend et équipes d’intégration de systèmes |
| AI Gateway | Modèle de routage centralisé pour les requêtes et le suivi de la consommation | Portail de plateforme ou adresse auto-hébergée | Appartient aux capacités de la plateforme | Équipes ayant besoin d’une gouvernance unifiée des modèles |
Fonction principale
Visualisation des agents intelligents et création de flux de travail
Les utilisateurs peuvent relier des nœuds d’entrée, d’agent, d’outil et de sortie sur la toile de projection, et configurer la mise en correspondance des données entre les nœuds. Une fois le flux de travail enregistré, une version est créée, ce qui facilite les tests, la publication et le retrait des modifications.
- Combinez des agents, des modèles, des outils, une base de connaissances et de la logique métier à l’aide d’une toile de développement low-code.
- Prend en charge la séquence, le parallélisme, les branches conditionnelles et l’orchestration de multiples agents.
- On peut commencer par un flux de travail initial généré à partir d’une toile blanche, d’un modèle ou de mots-clés.
- Le panneau de test permet de faire fonctionner directement la toile et d’afficher les entrées, sorties et erreurs des nœuds.
- Les mécanismes de version et de déploiement permettent de fixer le flux de travail en phase de test en une version déployable.
Nœud d’agent et appel d’outil
Les nœuds Agents peuvent être configurés avec des rôles, des modèles, des outils, une mémoire, un sandbox, des sous-agents et des sorties structurées. Les intelligences planifient et appellent les outils dans le cadre d’un cycle défini, jusqu’à ce que la tâche soit accomplie ou que des conditions de cessation soient déclenchées.
La gamme d’outils comprend la recherche sur le web, des sandbox de code, des requêtes de base de données, des services externes, des serveurs MCP et d’autres agents intelligents. Avant leur mise en ligne, il convient de définir des permissions, des délais d’expiration, un nombre maximal de cycles ainsi qu’une confirmation manuelle pour les outils à haut risque.
Base de connaissances et RAG
La base de connaissances Dynamiq constitue un processus complet d’ingestion qui comprend la conversion des fichiers, le broyage en blocs, l’incorporation et le stockage vectoriel. Les utilisateurs peuvent utiliser les paramètres par défaut ou choisir eux-mêmes la méthode de broyage en blocs, le fournisseur d’incorporation et la base de données vectorielle.
- Par défaut, le convertisseur multi-fichiers peut traiter les PDF, PPTX, DOCX, les images et le texte en fonction du type de fichier.
- Les paramètres de partitionnement, le modèle d’incorporation et l’emplacement de stockage des vecteurs sont ajustables.
- Une fois la base de connaissances créée, des tests de recherche peuvent être exécutés, puis elle peut être connectée au nœud Agent.
- Les frameworks Python prennent en charge des systèmes de stockage tels que Pinecone, Qdrant, Weaviate, Chroma, Milvus, pgvector et Elasticsearch.
- Avant de stocker les données de l’entreprise, il convient de confirmer les droits d’accès, la durée de conservation et les limites des données des modèles tiers.
Déploiement et interfaces d’application
Les workflows enregistrés peuvent être déployés en tant qu’applications, chacune disposant d’un point de terminaison d’appel indépendant. La plateforme prend en charge le retour synchronisé, la sortie par flux, l’interaction bidirectionnelle via WebSocket et les rappels asynchrone.
Le déploiement est fixé à une version de flux de travail spécifique, et la page d’application offre des accès au historique, au suivi, aux sessions, aux intégrations, aux déclencheurs et aux tests. En cas de problème avec une nouvelle version, il est possible de revenir à une version antérieure en se basant sur l’historique des déploiements.
Observabilité et suivi en temps réel
La plateforme enregistre l’arbre d’exécution du flux de travail, les boucles d’agent, les appels d’outils, les requêtes de modèles, les retards et la consommation de tokens. Les développeurs peuvent identifier les problèmes liés aux prompts, aux modèles, aux connexions ou à la mise en correspondance des données à partir des nœuds échoués.
Évaluation et contrôle de qualité
Dynamiq permet de créer des exécutions d’évaluation à l’aide de jeux de données, de versions de flux de travail et d’indicateurs d’évaluation. Les indicateurs peuvent être des indicateurs prédéfinis, des prompts d’évaluation pour LLM ou du code Python personnalisé.
- Les indicateurs prédéfinis incluent la fidélité, la précision dans le contexte, le taux de rappel dans le contexte et la justesse factuelle, entre autres.
- L’ensemble de données d’évaluation peut mapper les problèmes, le contexte, les réponses correctes et les sorties du flux de travail.
- Le même ensemble de données permet de comparer plusieurs flux de travail ou versions, afin de déterminer si les modifications sont efficaces.
- Les résultats de l’évaluation dépendent toujours du modèle d’évaluation et de la qualité du jeu de données, et ne peuvent pas remplacer l’inspection manuelle.
Guardrails et sortie structurée
La plateforme offre une vérification des résultats, un contrôle des risques et des contraintes sur les résultats structurés, et peut exiger que les modèles suivent des formats tels que JSON ou YAML. Guardrails permet de réduire la probabilité que des résultats non conformes pénètrent dans les systèmes métier, mais ne peut pas garantir que les modèles soient toujours corrects.
Ajustement du modèle
La plateforme d’entreprise permet d’ajuster les grands modèles open source à l’aide de données privées, et peut être déployée sur une infrastructure dédiée ou dans une VPC d’entreprise. Les données d’entraînement, la propriété des modèles, les coûts de calcul ainsi que la portée du support sont déterminés par le contrat entreprise.
Collaboration d’équipe et gouvernance
La plateforme gère les ressources par organisation, projet et flux de travail, et offre des connexions partagées, un contrôle d’accès ainsi que des Guardrails au niveau de l’entreprise. Les clés d’accès peuvent être limitées à un seul projet ou définies au niveau de l’organisation.
Framework open source Python
Dynamiq est le framework d’orchestration open source en Python qui se trouve derrière le système d’exécution de la plateforme, et peut être installé via PyPI. Les développeurs peuvent combiner dans du code des modèles, des agents, des outils, des rechercheurs, des embeddeurs et des workflows, pour les exécuter dans leur propre environnement Python.
| Capacité de cadre | effet | Utilisations typiques |
|---|---|---|
| Workflow, Flux et Nœuds | Déclarer un graphe orienté sans boucles et exécuter automatiquement les nœuds sans dépendances | Traitement des données et pipelines d’IA à plusieurs étapes |
| Agents | Planifier, appeler des outils et effectuer des tâches en boucle | Assistant de recherche, assistant de codage et agent métier |
| Graph Orchestrator | Créer un état machine personnalisé et un routage conditionnel | Collaboration complexe entre plusieurs agents intelligents et intervention humaine |
| Composant RAG | Conversion, partitionnement, insertion, écriture et récupération | Questions-réponses sur les connaissances de l’entreprise et recherche de documents |
| Streaming et Callbacks | Émettre un flux de tokens et surveiller le cycle de vie en cours | Interface de chat et surveillance en temps réel |
| Memory | Enregistrer et récupérer l’état de la session | Dialogues multiples et tâches à long terme |
| Checkpoints | Enregistrer un snapshot du processus et le reprendre à l’endroit où il a été interrompu | Rétablissement en cas de panne, attente d’une saisie manuelle et rétrocession dans le temps |
| Capacités d’ingénierie | Réessayer, mettre en cache, annuler et évaluer | Fonctionnement stable pour un environnement de production |
Modèles et composants de données pris en charge
La documentation officielle de l’SDK énumère des fournisseurs de modèles tels que OpenAI, Anthropic, Gemini, Bedrock, Mistral, Groq, Ollama, Azure AI et Together AI, et indique qu’il en existe d’autres encore. Les noms spécifiques des modèles ainsi que les régions disponibles sont déterminés par les fournisseurs respectifs.
La mémoire de session peut utiliser des backends tels que la mémoire vive, SQLite, PostgreSQL, Qdrant, Pinecone, Weaviate et DynamoDB. Lors de l’intégration de modèles et de bases de données tiers, l’utilisateur doit également assumer les comptes correspondants, les frais et les conditions de service.
Principe de fonctionnement
- Déterminer les tâches à accomplir par l’agent, les champs d’entrée, la structure de sortie et les outils pouvant être appelés.
- Créez des workflows dans une plateforme de visualisation ou du code Python, et configurez les connexions de modèle ainsi que les clés.
- Pour obtenir des données privées, créez une base de connaissances et effectuez la conversion des fichiers, leur segmentation, leur insertion et leur indexation.
- Connectez les nœuds Input, Agent, Outils, Base de connaissances et Output, et mappez les champs entre les nœuds.
- Utilisez des entrées d’exemple pour tester le flux de travail et vérifier chaque nœud, chaque appel d’outil ainsi que le suivi de l’exécution.
- En évaluant les ensembles de données et les résultats de comparaison des indicateurs, on corrige les prompts ainsi que la logique de recherche et d’acheminement.
- Enregistrer et publier une version du flux de travail, puis le déployer en tant qu’application avec des endpoints indépendants.
- Créer une clé d’accès, appeler l’application dans le système métier, et surveiller en continu les coûts, les délais et les erreurs.
Tutoriel d'utilisation
Créer le premier agent sur la plateforme de visualisation
- Inscrivez-vous et accédez aux organisations et projets, en créant d’abord une connexion avec le fournisseur de modèles requis.
- Ouvrez Workflows et créez un nouveau flux de travail ; vous pouvez fermer la bibliothèque de modèles pour commencer sur une toile blanche.
- Ajouter des nœuds Input pour déclarer les champs d’entrée tels que les questions des utilisateurs.
- Ajouter un nœud Agent, configurer les rôles, les modèles, les outils, le nombre de cycles et les exigences de sortie.
- Connectez l’Input à l’Agent et mappez les champs d’entrée aux tâches de l’Agent.
- Ajouter un nœud Output pour mapper les résultats de l’Agent en sortie finale.
- Exécuter des exemples sur le panneau de test, examiner le suivi et corriger les erreurs de connexion ou de champ.
- Enregistrez le flux de travail et créez une version à publier, afin de se préparer aux déploiements ultérieurs.
Créer et connecter une base de connaissances RAG
- Accédez à la page des bases de connaissances du projet et créez une base de connaissances.
- Saisissez le nom, développez les paramètres avancés si nécessaire pour sélectionner le convertisseur de fichiers, le segmentateur et le fournisseur d’incorporation.
- Choisissez le stockage vectoriel hébergé par une plateforme ou spécifié par l’entreprise, et confirmez les identifiants de connexion.
- Téléchargez des fichiers PDF, PPTX, DOCX, images ou textes dont les droits d’accès ont été vérifiés.
- Attendez que le flux de travail d’acquisition soit terminé, puis vérifiez les résultats de recherche à l’aide de questions représentatives.
- Connecter la capacité de recherche dans la base de connaissances à l’Agent, en précisant le degré de similarité, le nombre de résultats retournés et la manière de citer.
- Tester avec des cas sans réponse, des données contradictoires et des limites de droits pour éviter un mauvais usage de la base de connaissances.
Déployer et appeler une application d’agent intelligent
- Ouvrez le flux de travail enregistré, puis choisissez de créer une nouvelle déploiement ou de mettre à jour une application existante.
- Remplissez le nom et la description de l’application, sélectionnez l’environnement de exécution et fixez la version correcte du flux de travail.
- Attendez que l’état de déploiement soit réussi, puis confirmez la structure d’entrée et l’adresse de l’application sur la page d’intégration.
- Accédez aux paramètres de l’organisation pour créer une clé d’accès et la restreindre au projet correspondant.
- La clé n’est affichée complètement qu’une seule fois et doit être immédiatement sauvegardée dans le système de gestion des clés du serveur.
- Envoyez d’abord une requête depuis la page de test d’application, puis appelez depuis le backend avec des données en JSON.
- Activez la sortie en flux d’Agent pour obtenir du texte en temps réel, et traitez le flux d’événements sur le client.
- Après mise en ligne, vérifier le suivi, les tokens, les coûts, les délais et les erreurs, et mettre en place un processus de révocation des clés.
Installer un framework Python open source
- Préparez un environnement Python compatible et créez un environnement virtuel distinct pour le projet.
- Installez dynamiq à l’aide du gestionnaire de paquets Python, et installez les dépendances optionnelles selon le modèle ou le stockage souhaité.
- Placer les clés de modèle et de base de données dans des variables d’environnement, et ne pas les écrire directement dans le code source.
- Créer des nœuds de modèle, configurer les connexions, le modèle, les prompts et les paramètres de génération.
- Ajouter des nœuds au flux de travail, définir les dépendances et la mise en correspondance des entrées.
- Exécuter avec des données de test à petite échelle et vérifier l’état, les entrées et les sorties de RunnableResult.
- Ajoutez des tentatives de réessai, du cache, des appels en retour, des points de contrôle et le masquage des journaux avant de l’utiliser en production.
- Si vous avez besoin du suivi de la plateforme ou d’un déploiement hébergé, configurez alors les appels de retour de la plateforme, la CLI ou AI Gateway.
API, clés et intégration
L’API REST de Dynamiq couvre les applications déployées, le fonctionnement, les sessions, la base de connaissances, l’évaluation, les indicateurs, les ensembles de données, le suivi et AI Gateway. Les déploiements auto-hébergés peuvent utiliser leur propre nom de hôte, mais les chemins et la structure des requêtes restent identiques.
| Preuve | Utilisation principale | Champ des droits d’accès | Points clés de sécurité |
|---|---|---|---|
| Access Key | Appeler les applications déployées, les services de raisonnement et AI Gateway | Niveau organisationnel ou projet spécifié | La clé complète n’est affichée qu’une seule fois lors de sa création, et une date d’expiration peut être définie. |
| Personal Access Token | Appel de l’API de gestion | Exécuter des opérations de gestion au nom d’utilisateurs spécifiques | Les droits sont généralement plus élevés et ne doivent pas être utilisés pour le front-end ou les scripts partagés. |
| Clé du fournisseur tiers | Appeler des services externes tels que des modèles, des moteurs de recherche, des bases de vecteurs, etc. | Déterminé par la connexion correspondante | Sauvegarder par environnement et restreindre les droits d’accès ainsi que les frais |
- Les appels d’application prennent en charge les résultats synchrones et les flux d’événements du serveur.
- WebSocket convient aux interactions bidirectionnelles et aux tâches nécessitant un retour humain.
- Le mode asynchrone permet d’envoyer les résultats à l’adresse de callback une fois la tâche longue terminée.
- Les données d’entrée de l’application doivent correspondre à la structure des champs du nœud Input du flux de travail.
- Toutes les entrées externes doivent faire l’objet d’une vérification de type, de longueur et de contenu.
- Une clé doit être annulée immédiatement en cas de fuite, il ne suffit pas de modifier uniquement la configuration du client.
Mode de déploiement
| Méthode | Emplacement des infrastructures | Caractéristiques principales | Scénarios adaptés |
|---|---|---|---|
| Plateforme cloud Dynamiq | Environnement de hébergement officiel | Après l’enregistrement, vous pouvez créer, tester et déployer rapidement. | Prototypes, essais et projets d’équipe standards |
| VPC d’entreprise | Compte cloud du client | Déploiement via Kubernetes et Helm, avec préservation du contrôle réseau et des données | Finances, santé et activités réglementées |
| Infrastructure locale ou propre | Environnement de contrôle de l’entreprise | Soutien à des mesures de sécurité, d’accès et de traitement des données sur mesure | Résidence stricte des données et intégration au réseau privé |
| Framework Python open source | Tout environnement de exécution compatible avec Python | Le code s’exécute de manière autonome ; il est possible de choisir de se connecter ou non à une plateforme commerciale. | Expérimentations des développeurs, services auto-gérés et intégration dans des systèmes existants |
L’installation d’une VPC d’entreprise implique une abonnement au marché cloud, un cluster Kubernetes, des bases de données, du stockage d’objets, une gestion des clés et le déploiement de conteneurs. Il ne s’agit pas d’une installation desktop qui peut se faire en un seul clic ; elle nécessite des compétences en DevOps ou en ingénierie de plateforme.
Prix et forfaits
Au 22 août 2026, le site officiel propose une option « Commencer gratuitement », mais ne divulgue pas les prix fixes des forfaits des plateformes cloud traditionnelles ni le montant exact de l’accès gratuit. La VPC d’entreprise dispose de tarifs annuels sur AWS Marketplace ; pour les autres services d’entreprise, il faut contacter le service commercial.
| Plan | Prix | Période de facturation | Droits fondamentaux ou portée | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Framework Python open source | Gratuit | Pas de abonnement | Licence Apache 2.0, permettant d’exécuter des workflows, des agents et du code RAG de manière indépendante | Développeurs et projets auto-gérés |
| Plateforme cloud Dynamiq | On peut commencer gratuitement, le prix unitaire fixe n’est pas indiqué sur la page publique. | Selon la page de compte ou de règlement | Construction visuelle, base de connaissances, déploiement, suivi, évaluation et fonctionnalités d’équipe | Essai personnel et équipe produit |
| Enterprise VPC | 100 000 dollars | Contrat de 12 mois | Sans limite de nombre d’utilisateurs, flux de travail déployé, base de connaissances RAG et exécution mensuelle, avec support dédié et déploiement dans une VPC | Grandes entreprises et secteurs réglementés |
| AI Agent Factory | Cotation sur mesure | Par projet | Concevoir, développer et déployer des agents d’entreprise au cours d’une période convenue | Entreprises ayant besoin de mettre en œuvre des services |
Précautions concernant les prix
- Le prix public du contrat VPC pour les entreprises provient de la page produit actuelle d’AWS Marketplace ; le contrat final et les conditions s’appliquent selon la page d’achat.
- En plus des contrats d’entreprise, il peut être nécessaire de payer pour les serveurs cloud, les bases de données, le stockage d’objets, l’inférence de modèles et les bases de données vectorielles.
- Le fait que les frameworks open source soient gratuits ne signifie pas que les modèles, recherches, environnements sandbox et services de base de données associés le soient également.
- L’entrée gratuite sur le site officiel ne mentionne aucune promesse concrète quant au montant, et ne doit pas être présentée comme un service gratuit permanent.
- Les forfaits d’entreprise, les niveaux de support, SSO et les accords de conformité peuvent être personnalisés selon le contrat.
À qui s’adresse-t-il
- Développeur d’applications d’IA : Créer des agents, des RAG et des flux de travail à plusieurs étapes à l’aide de Python ou de tableaux de visualisation.
- Équipe de produits : tester rapidement les prototypes d’agents intelligents et les déployer en applications pouvant être appelées depuis le front-end ou le back-end.
- Équipe d’ingénierie de plateforme : gestion unifiée des connexions de modèle, des clés, du suivi, de l’évaluation et des versions d’applications.
- Équipe des données et de l’apprentissage automatique : création de bases de connaissances, comparaison des performances des modèles et affinement des modèles open source.
- Entreprises régulées : Déployées dans une VPC ou sur des infrastructures propres, avec un contrôle d’accès et des protocoles de conformité.
- Développeurs open source : Étendre les capacités de nœuds, d’outils, de stockage et d’orchestration du framework Apache 2.0.
Scénarios d'utilisation typiques
- Créer un assistant de questions-réponses interne qui relie la base de connaissances de l’entreprise, et restreindre l’accès aux données par le biais du contrôle des droits.
- Créer des agents intelligents de recherche capables de rechercher, d’appeler des outils et de générer des résultats structurés.
- Laisser plusieurs agents intelligents s’occuper respectivement de la recherche, de l’analyse et de la rédaction, puis faire un résumé par l’agent de gestion.
- Combinez la classification du service client, l’extraction d’informations et le traitement des tickets en un flux de travail automatisé.
- Utiliser l’ensemble de données d’évaluation pour comparer les prompts, les modèles, les paramètres de recherche et les versions des flux de travail.
- Déployez le flux de travail testé en tant qu’API pour l’intégrer dans des sites web, des systèmes backend ou des applications mobiles.
- Exécuter des applications d’IA générative dans une VPC d’entreprise qui impliquent la création de données médicales, financières ou confidentielles internes.
Avantages du produit
- Il offre en même temps une plateforme de visualisation et un framework Python, permettant aux équipes low-code et codage de partager le système d’exécution.
- Couvrez la construction, la base de connaissances, le déploiement, le suivi, l’évaluation et la gouvernance ; il n’est pas nécessaire de choisir des outils séparément pour chaque étape.
- Le framework open source est licencié sous la licence Apache 2.0 et peut être exécuté et étendu dans son propre environnement Python.
- Prend en charge de nombreux fournisseurs de modèles et diverses bases de données vectorielles, réduisant la dépendance vis-à-vis d’une seule stack technologique.
- Le déploiement d’applications dispose de capacités telles que la fixation de version, le suivi, la sortie en flux et les rappels asynchrones.
- Les options VPC et self-hosted conviennent aux entreprises qui ont besoin de la rétention des données et de contrôles de sécurité personnalisés.
- Les clés d’accès peuvent être restreintes par projet et dotées d’une date d’expiration, ce qui facilite la gestion des droits d’accès au sein de l’équipe.
Restrictions d'utilisation et précautions
- La plateforme offre de nombreuses fonctionnalités, ce qui entraîne des coûts d’apprentissage entre l’organisation, les projets, les connexions, les flux de travail, les applications et les identifiants.
- Les forfaits cloud standards et les quotas gratuits ne sont pas listés en détail sur la page publique ; il est nécessaire de les vérifier dans le compte avant de les utiliser.
- Les frameworks open source nécessitent Python, une interface de modèle, ainsi que de l’expérience en matière de stockage et de déploiement ; ce ne sont pas des outils de chat prêts à l’emploi destinés aux utilisateurs ordinaires.
- Le déploiement d’une VPC d’entreprise implique Kubernetes, des réseaux cloud, des bases de données et une gestion des clés, ce qui nécessite une équipe spécialisée en maintenance.
- Les sorties des modèles, les résultats des outils et la recherche RAG peuvent tous commettre des erreurs ; les processus à haut risque doivent faire l’objet d’une vérification manuelle.
- Les modèles tiers, la recherche, les sandbox de code et les bases de données vectorielles entraînent des coûts supplémentaires ainsi que des étapes de traitement des données.
- Les boucles Agent et les appels d’outils parallèles peuvent augmenter rapidement les tokens, les délais et les coûts ; il convient donc de définir des budgets et des conditions d’arrêt.
- La sortie structurée et Guardrails ne peuvent qu’atténuer les risques, mais ne peuvent pas prouver que le contenu est vrai ou conforme.
- Les conditions de service de la plateforme interdisent le reverse engineering des plateformes propriétaires, et il est impossible d’étendre la licence du framework aux plateformes commerciales.
Confidentialité, sécurité et conformité
Selon la politique de confidentialité, Dynamiq traite les informations relatives aux comptes, aux factures, aux communications, aux appareils et à l’utilisation ; elle peut également traiter le contenu des documents, les métadonnées et les permissions de Google Workspace avec l’autorisation de l’utilisateur. Avant de se connecter aux données de l’entreprise, il convient de vérifier le mode de déploiement utilisé ainsi que les sous-traitants.
- Les données personnelles sont traitées sur la base de la prestation de services, de contrats, d’obligations légales ou d’intérêts légitimes, et sont supprimées ou anonymisées lorsque elles ne sont plus nécessaires.
- Les données de Google Workspace ne sont utilisées que dans les limites autorisées pour des fonctions telles que les recherches, les extractions, les résumés et les questions-réponses demandés par l’utilisateur.
- La déclaration officielle indique qu’aucuns données brutes de Google Workspace, données dérivées, embeddings, prompts ou résultats n’étaient utilisés pour entraîner le modèle de base général.
- Après la déconnexion de Google Workspace, les données en cache seront supprimées ou anonymisées conformément aux règles de conservation, sauf en cas d’obligations légales ou autres exceptions.
- Les services peuvent faire appel à des sous-traitants tiers pour l’hébergement, l’analyse et l’IA ; les entreprises doivent examiner la liste actuelle ainsi que les accords de traitement des données avant d’effectuer une acquisition.
- Le traitement d’informations médicales soumises à la réglementation HIPAA nécessite la signature d’un accord avec un partenaire commercial ; il n’est pas possible de l’utiliser directement en se basant uniquement sur les informations disponibles sur le site web.
- L’autogestion ou les VPC peuvent renforcer le contrôle des données, mais les fournisseurs de modèles, les outils externes et les configurations opérationnelles peuvent encore constituer des points d’exportation de données.
Plateforme de support
| Plateforme ou méthode | Soutien disponible | Explication |
|---|---|---|
| Plateforme de gestion web | Soutien | Utilisé pour la visualisation de la construction, des bases de connaissances, du déploiement, du suivi et de la gestion |
| Python | Soutien | Le framework open source officiel est publié en tant que package Python |
| REST API | Soutien | Utilisé pour le fonctionnement des applications, la gestion, la base de connaissances, l’évaluation et le gateway |
| Appels clients en Python et TypeScript | Soutien | Le tutoriel officiel de déploiement fournit des exemples d’appel. |
| Autres langages backend | Soutien | Il suffit d’envoyer une requête réseau standard pour appeler l’application déployée. |
| AWS VPC | Soutien | Déploiement via AWS Marketplace, Kubernetes et Helm |
| Auto-hébergement | Soutien | Utiliser l’adresse et l’infrastructure propres à l’entreprise |
| Environnements de développement Windows, macOS et Linux | Selon l’environnement Python | Les frameworks open source peuvent fonctionner dans des environnements compatibles avec Python. |
| Application native iOS ou Android | Aucun résultat trouvé | Les développeurs peuvent intégrer l’application déployée à leurs produits mobiles. |
| Extension de navigateur | Aucun résultat trouvé | L’accent officiel est mis sur les plateformes Web, les API et les SDK. |
API, SDK et situation du logiciel open source
Dynamiq propose une API REST et un framework Python officiel. L’API sert à appeler les applications déployées, à gérer les ressources de la plateforme telles que les exécutions et la base de connaissances, tandis que le framework Python peut fonctionner de manière indépendante ou se connecter à la plateforme pour assurer le suivi, le routage par gateway et le déploiement hébergé.
| Projet | Est-ce ouvert | Licence ou nature | Explication |
|---|---|---|---|
| Plateforme commerciale Dynamiq | Non | SaaS propriétaire et logiciels d’entreprise | Les conditions de service stipulent clairement que les droits de propriété intellectuelle de la plateforme appartiennent à Dynamiq. |
| Framework Python Dynamiq | Oui | Apache 2.0 | Peut être installé via PyPI et le code source est disponible sur GitHub officiel. |
| REST API | Fournir | Interface de plateforme commerciale | L’ouverture des appels ne signifie pas l’ouverture du code source de la plateforme |
| AI Gateway | Fournir | Services de plateforme | Utilisé pour le routage des modèles, la gestion centralisée des clés et le suivi de la consommation |
| Composant d’interface Assistant | Oui | Apache 2.0 | Il existe également des composants de chat React et JavaScript officiels destinés aux applications d’agent. |
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | Dynamiq |
| Société de développement | Dynamiq Technologies, Inc. |
| Type d’outil | Plateforme d’agents intelligents IA, orchestration de workflows, RAG et LLMOps |
| Capacité centrale | Visualisation des workflows, Agents, base de connaissances, déploiement, suivi, évaluation, Guardrails et fine-tuning |
| Modèle de prix | Les frameworks open source sont gratuits, les plateformes cloud offrent un démarrage gratuit, contrats entreprise et devis sur mesure. |
| Exigences d’inscription | Pour utiliser une plateforme cloud, il est nécessaire de s’inscrire ; les frameworks open source peuvent être installés indépendamment. |
| Soutien en chinois | Il est possible de se connecter à des modèles prenant en charge le chinois, l’interface de la plateforme étant principalement en anglais. |
| API | Oui |
| SDK officiel | Oui, des frameworks Python |
| Statut open source du produit | Les plateformes commerciales ne sont pas open source |
| Composants open source | Framework Dynamiq Python et composants d’interface Assistant |
| Licence open source | Apache 2.0 |
| Plateformes principales | Web, Python, REST API, AWS VPC et auto-hébergement |
Indice de recommandation
Le score de recommandation est de 4,3 sur 5. Dynamiq relie la construction visuelle, les cadres d’orchestration open source, RAG, le déploiement, le suivi et l’évaluation en une chaîne complète, ce qui le rend adapté aux équipes de développement d’IA qui souhaitent passer du prototype à la production.
Le principal défaut réside dans le manque d’information claire sur les prix en cloud et les quotas gratuits, ainsi que dans le fait que le concept de plateforme et son déploiement en entreprise présentent des difficultés d’apprentissage et de maintenance. Les utilisateurs ordinaires qui souhaitent simplement discuter ou créer du contenu n’ont pas besoin de choisir ce type de plateforme de développement.
Questions fréquentes
Quel outil est Dynamiq ?
C’est une plateforme utilisée pour construire, déployer et gérer des agents intelligents d’IA et des applications LLM, tout en fournissant un framework d’orchestration Python open source. Ce n’est pas un chatbot destiné aux utilisateurs ordinaires.
Dynamiq est-il gratuit ?
Les frameworks Python open source peuvent être utilisés gratuitement, et la plateforme cloud officielle propose également un point d’accès gratuit pour commencer, mais les pages publiques ne précisent pas clairement les quotas gratuits habituels ni les prix des forfaits fixes. Les modèles, les bases de données et les ressources cloud peuvent faire l’objet de frais supplémentaires.
Dynamiq est-il open source ?
Il faut juger séparément : le framework Dynamiq Python est distribué sous la licence Apache 2.0 et son code source est public, tandis que la plateforme commerciale Dynamiq est un logiciel propriétaire. On ne peut pas qualifier toute la plateforme de logiciel open source simplement parce que son framework l’est.
Une API est-elle disponible ?
Fourni. L’API REST couvre les applications déployées, le fonctionnement, les sessions, la base de connaissances, l’évaluation, les ensembles de données, le suivi et AI Gateway ; la même structure de chemins est également disponible pour les environnements auto-hébergés.
Un SDK officiel est-il fourni ?
Il fournit un framework Python qui peut être installé via un gestionnaire de paquets. Il permet de faire fonctionner des workflows de manière indépendante, tout en permettant de se connecter à des plateformes commerciales pour obtenir des fonctionnalités de suivi, de passerelle et de déploiement hébergé.
Quels grands modèles sont pris en charge ?
Le cadre officiel énumère des fournisseurs tels que OpenAI, Anthropic, Gemini, Bedrock, Mistral, Groq, Ollama, Azure AI et Together AI. La disponibilité réelle des modèles selon la région est déterminée par le service correspondant.
Est-il possible de créer une base de connaissances entreprise ?
Oui. La plateforme peut effectuer la conversion de fichiers, le découpage en blocs, l’incorporation, le stockage et la recherche vectorielle, ainsi que relier la base de connaissances à l’Agent ; les frameworks personnalisés prennent également en charge diverses bases de données vectorielles.
Prendre en charge le déploiement privé ?
Prend en charge les VPC d’entreprise et les déploiements auto-hébergés ; la documentation officielle contient une procédure d’installation de Kubernetes dans un environnement AWS. La mise en œuvre réelle nécessite une infrastructure cloud, des bases de données, du stockage ainsi que des capacités de gestion des clés.
Les résultats générés peuvent-ils être utilisés directement dans des activités à haut risque ?
Il n’est pas recommandé de l’utiliser directement sans vérification. Les agents, les modèles, les outils et les résultats de recherche peuvent contenir des erreurs ; dans les domaines médical, financier, juridique et pour les tâches d’exécution automatique, il convient d’introduire des évaluations, des restrictions de droits et une approbation manuelle.
Les données des utilisateurs seront-elles utilisées pour l’entraînement ?
Les autorités ont clairement indiqué que les données de Google Workspace ne seront pas utilisées pour entraîner ou améliorer des modèles de base généraux, mais cette promesse s’applique uniquement à ce type de données. Le traitement des autres données doit être vérifié case par case en fonction de la politique de confidentialité, du mode de déploiement, des sous-traitants et des contrats avec l’entreprise.
Quel est le prix d’une VPC d’entreprise ?
Au 22 août 2026, le prix annuel du contrat Enterprise VPC affiché sur AWS Marketplace est de 100 000 dollars ; les coûts liés à l’infrastructure cloud et aux modèles externes peuvent être facturés séparément. Les conditions finales sont indiquées sur la page d’achat et dans le contrat.
Dynamiq convient-il aux utilisateurs ordinaires ?
Il s’adresse principalement aux développeurs, aux équipes de produits et aux équipes de plateformes d’IA d’entreprise. Pour ceux qui ont simplement besoin de discuter au quotidien, d’écrire ou de générer des images, utiliser des applications d’IA prêtes à l’emploi est plus direct.
Résumé
La valeur de Dynamiq réside dans le fait qu’il unifie le développement d’agents, RAG, le déploiement, le suivi et l’évaluation, et permet aux équipes de choisir entre une plateforme visuelle et du code Python open source. Il offre des capacités d’ingénierie assez complètes pour les organisations ayant besoin d’agents de niveau production et de déploiements privés.
Avant de choisir, il convient de vérifier en particulier le forfait cloud, les coûts des modèles tiers, les responsabilités de déploiement et les protocoles de traitement des données. Lorsque l’on utilise des frameworks open source, il faut également mettre en place soi-même des systèmes d’authentification, de surveillance, de contrôle budgétaire, d’évaluation et de maintenance.
Outils similaires à Dynamiq

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164