




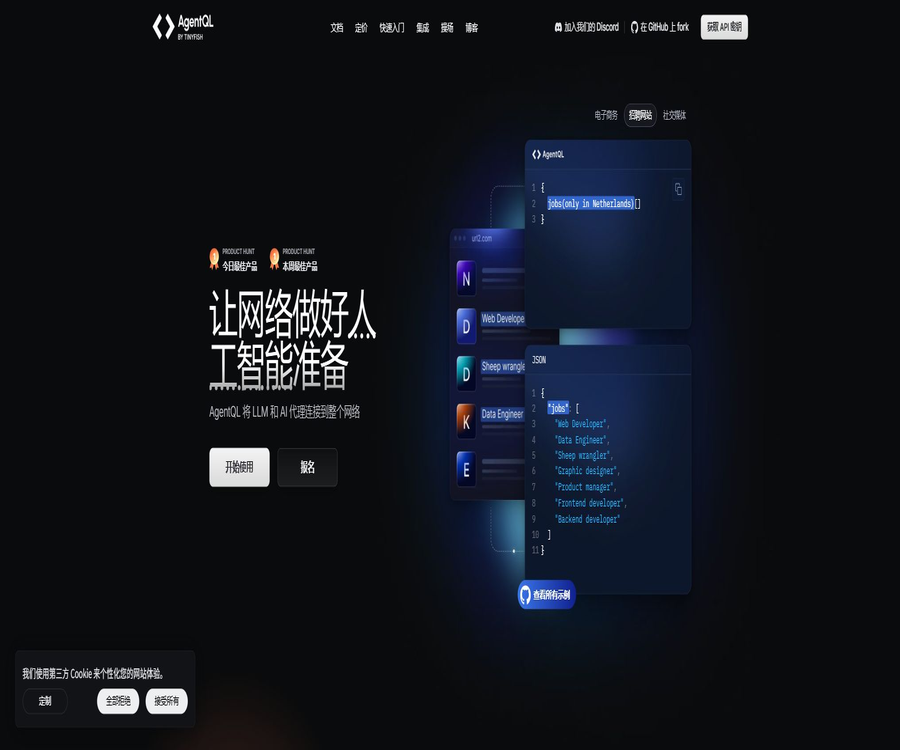
AgentQL
AgentQL, outil intelligent axé sur la conception par IA
Étiquettes :Outils de conception IAQu’est-ce qu’AgentQL ?
AgentQL est un ensemble de langage de requête web et d’outils de développement basés sur l’IA, développé par TinyFish, qui permet de décrire les données ou les éléments de page souhaités en langue naturelle. Il est adapté à la création d’outils d’extraction de données de sites web, à l’automatisation des navigateurs, aux processus de test, ainsi qu’à des agents IA capables d’utiliser des sites web.
Contrairement aux scripts qui dépendent de sélecteurs CSS ou XPath fixes, AgentQL localise les éléments en se basant sur leur signification, leur contexte et la structure de la requête. Lorsque le layout de la page change, les requêtes sémantiques sont généralement plus faciles à réutiliser que les sélecteurs de position, mais il reste nécessaire de tester et de gérer les exceptions pour assurer la fiabilité en production.
Fonctionnalités clés
- Utiliser des noms de champs en langage naturel pour localiser les éléments et les données de la page web
- Retourner des objets imbriqués ou des listes selon la structure de la requête
- Utiliser Playwright avec Python et JavaScript pour automatiser les opérations sur les pages web
- Lancer des requêtes de données via une API REST depuis n’importe quel langage de programmation
- Utiliser un navigateur à distance pour exécuter des tâches nécessitant une session et une interaction
- Extraction de contenu structuré à partir de pages web, de PDF et d’images
- Utiliser l’extension Debugger pour déboguer les requêtes sur des pages web réelles
- Tester les prompts dans Playground et exporter le script
- Connecter l’écosystème d’automatisation LangChain, Zapier et MCP
Langage de requête AgentQL
Les requêtes AgentQL définissent, grâce à la structure des champs, ce qu’il faut rechercher et à quoi ressembleront les résultats ; les noms des champs peuvent eux-mêmes exprimer une signification. Des listes, des objets imbriqués et des notes complémentaires peuvent être utilisés ensemble pour rendre la structure de la sortie plus claire avant son exécution.
| Capacité de recherche | effet | Utilisations d’exemple |
|---|---|---|
| Champ sémantique | Identifier les éléments selon le nom et le contexte | Champ de recherche par localisation, prix ou bouton « Page suivante » |
| Liste | Renvoie plusieurs éléments du même type | Extraire la liste de produits, d’articles ou de commentaires |
| Structure imbriquée | Exprimer les relations entre les champs internes du projet | Chaque produit comprend un nom, un prix et une note. |
| Instructions en langage naturel | Ajouter une position, une signification ou des conditions de filtrage | Définir les titres dans le corps du texte ou des cartes spécifiques |
| Conversion de données | Organiser les résultats extraits par type de cible | Organiser les prix en valeurs numériques |
| Recherche rapide | Deduire la structure de données à partir d’une description complète | Explorer rapidement les pages non encore modélisées |
Le fonctionnement de la localisation sémantique
- Comprendre la signification métier des noms de champs sur la page actuelle
- Déterminer l’objectif en se basant sur le texte environnant, les étiquettes et la hiérarchie de la page
- Il n’est pas exigé que les développeurs connaissent à l’avance le chemin DOM spécifique.
- Pour les sites similaires, on peut essayer de réutiliser la même structure de requête.
- Même après le réarrangement de la page, il est possible de trouver des éléments ayant la même signification.
- Lorsque l’ambiguïté est forte, on peut ajouter des explications plus spécifiques en langage naturel.
Extraction de données de page web
Les développeurs peuvent utiliser un SDK ou une API REST pour extraire des données structurées des pages web publiques ainsi que des pages autorisées. La structure de sortie est définie par la requête, ce qui permet de réduire les tâches de nettoyage ultérieures, mais les valeurs manquantes, les doublons et l’état des pages doivent encore être gérés dans le code métier.
- Collecte du nom du produit, du prix, des stocks et des avis
- Organisation des titres de nouvelles, dates, auteurs et texte
- Extraction des résultats de recherche, du catalogue et des listes paginées
- Collecte autorisée des données en arrière-plan après connexion
- Chargement dynamique et gestion des pages avec défilement infini
- Sortie de champs unifiés entre sites similaires
Automatisation des navigateurs
Les SDK Python et JavaScript d’AgentQL s’appuient sur le flux de travail Playwright et permettent de récupérer des éléments de page que l’on peut cliquer, remplir et lire. Les développeurs peuvent toujours utiliser les fonctionnalités de Wait, de contexte du navigateur, de réseau et d’assertions de Playwright.
- Ouvrez la page web et localisez les champs de saisie, les boutons et les menus
- Remplir le formulaire, choisir des options et soumettre la tâche
- Désactiver les alertes ou les fenêtres contextuelles des cookies
- Feuilleter, faire défiler et attendre l’apparition du contenu asynchrone
- Exécuter des opérations autorisées au cours d’une session de connexion
- Écrire les résultats de l’extraction dans le flux de travail des données suivant
SDK Python et JavaScript
| Méthode | Capacités principales | Adéquat pour les utilisateurs |
|---|---|---|
| Python SDK | Automatisation Playwright, recherche d’éléments et extraction de données | Ingénierie des données, recherche et développement d’agents Python |
| JavaScript SDK | Automatisation Playwright, recherche d’éléments et extraction de données | Équipes frontend, Node.js et d’ingénierie de tests |
| REST API | Rechercher directement sur des pages web, des documents et des navigateurs distants | Intégration avec d’autres langages ou services légers |
| Extension débogueur | Tester la requête dans les outils de développement du navigateur | Débogage et localisation de l’ambiguïté des requêtes |
| Playground | Tester les requêtes, obtenir des suggestions d’optimisation et exporter le script | Vérification du prototype et apprentissage |
| CLI | Initialiser l’environnement et créer un modèle de script | Créer rapidement un projet local |
Extraction d’API REST et de documentation
L’API REST peut être authentifiée à l’aide d’une clé API et renvoie des données structurées ; elle permet de consulter des pages web ainsi que de traiter des fichiers PDF et d’images. La consultation des documents s’effectue par page ou par image, ce qui exige une estimation du nombre de requêtes pour les gros fichiers.
- Appel depuis n’importe quel langage prenant en charge les requêtes réseau
- Utiliser Query pour spécifier précisément la structure ou utiliser Prompt pour décrire l’objectif
- Sélectionner le mode d’extraction rapide ou standard
- Créer une session de navigateur à distance pour exécuter des tâches interactives
- Configurer les caractéristiques du navigateur et l’emplacement du proxy
- Suivre les exécutions et les erreurs via l’identifiant de la demande
Navigateur à distance
L’abonnement AgentQL comprend un certain nombre d’heures d’utilisation du navigateur à distance et de sessions simultanées, permettant d’exécuter des workflows de pages web dynamiques dans le cloud. Les abonnements Starter et Professional diffèrent considérablement en termes d’heures allouées, de frais de surcroît et de limite de sessions simultanées.
- Exécuter des pages nécessitant JavaScript dans un environnement hébergé
- Session du navigateur nécessaire pour maintenir des interactions multi-étapes
- Configurer des agents d’exportation pris en charge par région
- Choisir une configuration de navigateur légère ou mettant davantage l’accent sur la lutte contre la détection
- Définir une durée de timeout pour les sessions inactives afin d’éviter que des sessions abandonnées ne consomment trop de ressources.
- Isoler les cookies, les connexions et le stockage local par tâche
Débogueur et Playground
L’extension débogueur ajoute un panneau AgentQL aux outils de développement du navigateur, permettant de tester des requêtes directement sur la page actuelle et de mettre en surbrillance les éléments correspondants. Le Playground est plus adapté pour explorer les requêtes, obtenir des suggestions d’optimisation et générer des scripts pouvant être développés davantage.
- Passer du mode de requête d’éléments au mode d’extraction de données
- Voir la zone de page où la requête a trouvé un résultat
- Vérifier si la liste de contrôle et la structure imbriquée correspondent aux attentes
- Ajouter un contexte en langage naturel aux champs ambigus
- Vérifier rapidement le site cible avant d’accéder au code
- Migrer les résultats validés vers le SDK ou l’API
Scénarios d’application
- Créer un agent IA capable d’accéder à des pages web et d’exécuter des tâches
- Récupérer des données de e-commerce, d’actualités, de catalogues ou de recherches publiques
- Remplissage automatique des formulaires des systèmes internes et du portail des partenaires
- Surveiller les changements de champs, de prix, d’état ou de contenu sur la page
- Fournir une localisation sémantique plus facile à maintenir pour les scripts de test
- Extraction d’informations sur des structures fixes à partir de PDF et d’images
- Collecte de données sur plusieurs sites ayant des structures différentes mais une signification similaire
- Intégrer les informations du site web à LangChain, Zapier ou des processus internes
À qui s’adresse-t-il
- Ingénieur en IA nécessitant un développement rapide d’agents web
- Développeurs Python et Node.js pour la maintenance de l’automatisation Playwright
- Équipes de données et de recherche nécessitant des données de pages web structurées
- Ingénieur en tests souhaitant réduire les coûts de maintenance des sélecteurs
- Équipe backend pour intégrer les données de la page web via une API REST
- Clients entreprises nécessitant un cloud privé ou une déploiement local
Prix d’AgentQL
AgentQL propose une version d’essai gratuite, ainsi que des plans Starter, Professional et Enterprise. Les prix publics sont affichés mensuellement ; l’API et le navigateur à distance sont facturés au forfait supplémentaire en dehors des quotas alloués.
| Plan | Frais mensuels | Plafond API et frais de dépassement | Navigateur à distance | Sessions simultanées |
|---|---|---|---|---|
| Essai gratuit | 0 dollar | 300 fois d’un coup ; 10 fois par minute | 1 heure | 1 |
| Starter | 0 dollar | 50 fois par mois ; 0,02 dollar par excès | 10 heures incluses ; 0,12 dollar par heure supplémentaire | 5 |
| Professional | 99 dollars | 10 000 fois par mois ; 0,015 dollar par excès | 500 heures incluses ; 0,10 dollar par heure supplémentaire | 100 |
| Enterprise | Cotation sur mesure | Conformément aux besoins de l’entreprise | Cloud dédié ou déploiement local | Conformément aux dispositions du plan |
L’essai gratuit ne nécessite pas de carte de crédit et convient pour tester les recherches ainsi que le navigateur à distance avant de choisir officiellement. Les frais de taxes, d’intermédiaires, de services professionnels ou de livraison pour entreprises sont éventuellement supplémentaires ; ils doivent être vérifiés sur la page de paiement et la commande.
Conseils pour le choix du forfait
| Demande | Proposition de solution | Raison |
|---|---|---|
| Vérification à court terme | Essai gratuit | 300 appels et 1 heure d’utilisation du navigateur pour une évaluation facile |
| Prototyp personnel ou tâches à faible fréquence | Starter | Pas de frais mensuels et prise en charge de l’extension selon la consommation |
| Flux de travail de données stable | Professional | Nombre d’appels, durée de navigation et concurrence plus élevés |
| Données à grande échelle ou sensibles | Enterprise | Données hébergées, cloud privé ou déploiement local disponibles |
Tutoriel pour commencer rapidement
- Inscrivez-vous en tant que développeur et créez une clé API.
- Installez l’extension Debugger et ouvrez les outils de développement sur la page web cible.
- Utilisez d’abord une recherche avec des champs simples pour localiser un élément précis.
- Définir la sortie complète à l’aide de listes et de structures imbriquées.
- Vérifiez séparément les éléments et les résultats des données dans le débogueur.
- Installez le SDK Python ou JavaScript et initialisez le projet.
- Ajoutez la requête vérifiée au script Playwright.
- Ajoutez le traitement des pages de attente, de réessai, de valeurs nulles et d’exceptions avant de le mettre en ligne.
Tutoriel d’extraction de données
- Vérifier les droits d’accès aux données cibles et les conditions du site.
- Listez les champs à retourner, leurs types et les relations hiérarchiques.
- Utilisez une liste pour les éléments répétitifs et créez une structure imbriquée pour les champs enfants.
- Sélectionnez des pages représentatives pour tester les champs normaux et manquants.
- Gérer la pagination, le défilement infini et l’état de chargement dynamique.
- Vérifier les doublons, les valeurs vides, le type et l’encodage des caractères.
- Définir des limites de fréquence, du cache et des tentatives de réessai en cas d’échec.
- Effectuer des échantillonnages réguliers pour comparer la page originale et détecter les changements de qualité.
Tutoriel de déploiement en production
- Estimer le nombre de pages web, de pages de documents et d’heures d’utilisation du navigateur à distance par mois.
- Choisissez le forfait adapté en fonction des limites de concurrence et de vitesse.
- Stockez la clé API dans un système de gestion des clés et restreignez son accès.
- Isoler les contextes de navigateur pour les sessions de connexion et différents clients.
- Définir des états clairs pour les délais dépassés, les codes de vérification, les bannissements et les modifications de page.
- Enregistrer l’identifiant de la demande, la cible, le temps écoulé, le résultat et la cause de l’erreur.
- Définir des alertes pour le nombre d’appels, la durée d’utilisation du navigateur et les coûts.
- Organiser une vérification manuelle des données à fort impact et des opérations automatisées.
Conseils de conception de requête
- Utiliser des noms de champs aux significations métier claires et stables
- Ajouter des descriptions de lieu et d’apparence uniquement si nécessaire
- Exprimer les relations réelles des données à l’aide de structures imbriquées
- Utiliser explicitement une liste pour plusieurs éléments
- Découper les pages complexes en petites requêtes vérifiables
- Accepter des valeurs vides pour les champs optionnels et enregistrer la raison de l’absence.
- Utiliser des pages représentatives et des pages anormales pour créer des tests de régression
Évaluation de la fiabilité et de la qualité
| Indicateur | Contenu de l’évaluation | Méthode recommandée |
|---|---|---|
| Précision du champ | Les valeurs extraites correspondent-elles à la page ? | Échantillonnage manuel par champ |
| Taux de complétude | Projets et champs cibles manquants ? | Par rapport au nombre total de pages |
| Taux de répétition | Le même enregistrement est-il retourné plusieurs fois | Créer une clé primaire d’entreprise pour éliminer les doublons |
| Taux de réussite du positionnement | Les éléments interactifs atteignent-ils leur cible de manière stable | Tests de régression entre layouts et états |
| Taux de réussite de la tâche | L’automatisation à plusieurs étapes est-elle terminée ? | Enregistrer l’état étape par étape |
| Coût unitaire | Coût des appels et du temps passé sur le navigateur | Calculé selon le nombre de réussites |
| Temps de récupération des changements de page | Impact de la mise à jour du site | Échec de la surveillance et maintien d’un processus de secours |
Sécurité et conformité
- Ne visiter que des pages et des comptes publics ou autorisés.
- Respecter les conditions du site, la fréquence d’accès et les restrictions d’utilisation des données
- Ne pas exposer la clé API dans les requêtes, les journaux ou le code.
- Mettre en œuvre l’isolation et le chiffrement des cookies, des sessions et des fichiers téléchargés
- Éviter de collecter des informations personnelles ou sensibles non liées à l’activité.
- Conserver une confirmation manuelle pour les opérations à fort impact telles que la soumission, l’achat et la suppression.
- Définir les taux, le budget et la liste des noms de domaine autorisés pour l’automatisation
- Préparation du code de vérification, blocage d’accès et processus de prise en charge manuelle
Avantages du produit
- La localisation en langage naturel est plus facile à comprendre et à maintenir que les chemins DOM fixes.
- La requête définit elle-même une sortie structurée, réduisant ainsi le code de post-traitement.
- Le même outil couvre à la fois l’extraction de données et l’interaction avec les pages web.
- Les SDK Python et JavaScript se connectent directement à Playwright
- L’API REST facilite l’accès depuis d’autres langages et pour des tâches sans état.
- Fournit un débogueur, un Playground, une CLI et de nombreux exemples
- Permet de consulter diverses sources telles que des pages web, des PDF et des images
- Le SDK principal et les exemples sont publiés sur GitHub sous la licence MIT.
Restrictions d'utilisation et précautions
- La localisation sémantique peut encore faire pointer vers un élément incorrect sur une page ambiguë
- L’accès au site, les codes de vérification et les mécanismes anti-automatisation peuvent bloquer le processus.
- Les pages dynamiques nécessitent une attente appropriée, on ne peut pas se fier uniquement à une seule requête.
- Une erreur dans le contenu de la page affecte directement les résultats de l’extraction.
- Les appels API et les navigateurs distants génèrent respectivement des coûts de consommation.
- PDF est appelé par page, le coût des fichiers volumineux augmente rapidement.
- Avant la réutilisation cross-site des requêtes, il est encore nécessaire de valider séparément la sémantique des champs pour chaque site.
- L’automatisation ne doit pas contourner les mesures de sécurité du site ou les restrictions d’accès.
- Contrairement aux SDK open source, une plateforme complète ne peut pas se reposer uniquement sur l’hébergement propre au dépôt.
GitHub et le monde du logiciel open source
Le dépôt GitHub officiel d’AgentQL met à disposition des intégrations en Python et JavaScript, des exemples ainsi que des ressources de développement, sous licence MIT. L’API hébergée, le navigateur distant, le portail des développeurs et les services d’entreprise restent des plateformes commerciales et ne doivent pas être considérés comme des services cloud entièrement open source.
| Composant | État | Explication |
|---|---|---|
| Répertoire officiel d’AgentQL | Open source du MIT | Inclut l’intégration SDK, des exemples et du code d’outils associés |
| Python SDK | Outils de développement officiels | Extraction et automatisation avec Playwright |
| JavaScript SDK | Outils de développement officiels | Destiné aux workflows Node.js et Playwright |
| REST API | Interface de gestion commerciale | Facturation selon le forfait et le volume d'utilisation |
| Navigateur à distance | Services de gestion commerciale | Facturation selon la durée d’utilisation et la quantité excédentaire |
| Enterprise | Livraison commerciale | Cloud dédié ou déploiement local disponible |
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | AgentQL |
| Société de développement | TinyFish |
| Type d’outil | Recherche sur le web avec l’IA, extraction de données et automatisation du navigateur |
| Langue principale | Python, JavaScript et API REST |
| Fondements de l’automatisation | Playwright |
| Contenu pris en charge | Pages web, PDF et images |
| Plan gratuit | Il y a une version d’essai gratuite et Starter |
| Déploiement d’entreprise | Cloud dédié ou déploiement local disponible |
| Est-ce open source | Le SDK principal et les exemples sont sous licence MIT ; la plateforme hébergée est un service commercial. |
Indice de recommandation
4,6 / 5. AgentQL convient aux développeurs et aux équipes d’agents qui souhaitent réduire les coûts de maintenance des sélecteurs de pages web grâce à des requêtes sémantiques ; son écosystème d’outils, son intégration avec Playwright et ses prix publics sont assez complets ; toutefois, pour un usage en production, il reste nécessaire de gérer l’ambiguïté des pages, les restrictions d’accès, le contrôle de qualité et les coûts à la consommation.
Questions fréquentes
À quoi sert principalement AgentQL ?
Il utilise des requêtes en langage naturel pour localiser les données et les éléments des pages web, et effectue l’extraction structurée ainsi que l’automatisation du navigateur via un SDK ou une API.
Quelle est la relation entre AgentQL et Playwright ?
L’SDK AgentQL ajoute des capacités de requêtes sémantiques aux workflows Playwright, tout en conservant les fonctionnalités existantes de contrôle du navigateur, d’attente et d’assertions.
AgentQL peut-il être utilisé gratuitement ?
Oui. L’essai gratuit offre 300 appels, tandis que Starter fournit 50 appels gratuits par mois et permet un paiement à l’utilisation.
Combien coûte Professional ?
Le prix public de Professional est de 99 dollars par mois, ce qui inclut 10 000 appels API et 500 heures d’utilisation du navigateur à distance.
AgentQL peut-il extraire des PDF ?
Oui, l’API REST prend en charge les PDF et les images ; les appels API pour les PDF sont généralement calculés par page.
Quelles langues AgentQL prend-il en charge ?
Des SDK pour Python et JavaScript sont fournis officiellement, tandis que d’autres langages peuvent se connecter via une API REST.
AgentQL peut-il gérer la page de connexion ?
Il est possible de traiter la page après connexion dans une session navigateur autorisée, mais il faut protéger les identifiants et respecter les règles du site.
AgentQL est-il open source ?
Le dépôt de code officiel est sous licence MIT, mais les API hébergées, le navigateur à distance et les services d’entreprise restent des produits commerciaux.
Les sélecteurs sémantiques resteront-ils toujours stables ?
Non. Il peut réduire la pression liée à la maintenance due aux changements dans la structure de la page, mais les ambiguïtés, les modifications du contenu et l’état d’accès peuvent encore entraîner des échecs.
Outils similaires à AgentQL

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164