




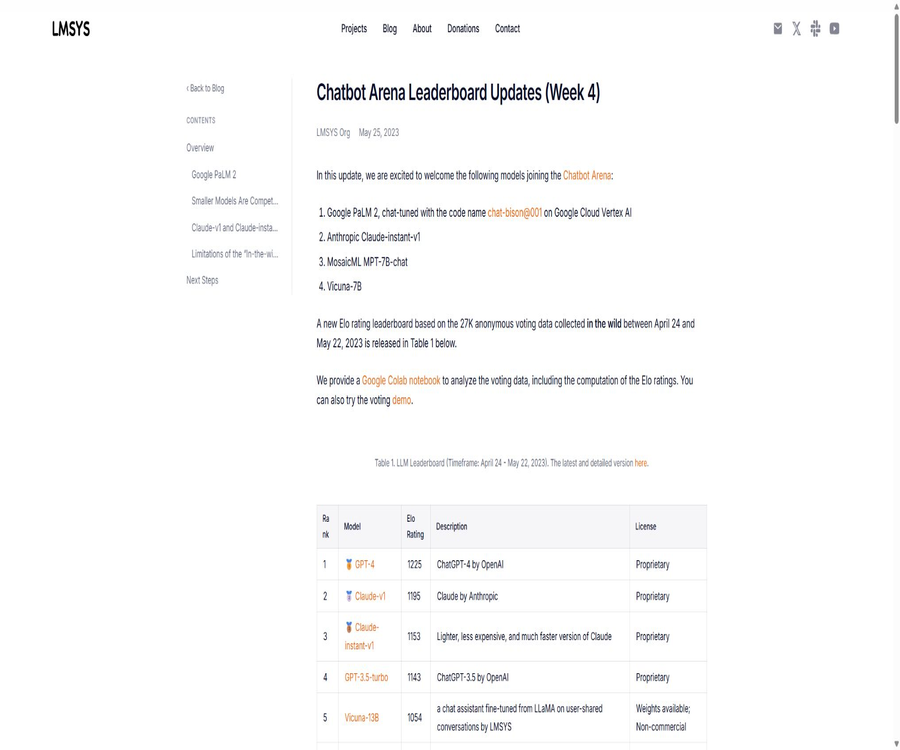
Chatbot Arena Leaderboard
Classement de Chatbot Arena, outil intelligent axé sur l’évaluation des modèles d’IA
Étiquettes :Évaluation des modèles d’IAQu’est-ce qu’Arena AI ?
Arena AI est une plateforme qui évalue les modèles d’IA générative par des comparaisons anonymes entre des utilisateurs réels ; elle est issue de Chatbot Arena et LMArena. Lorsque les utilisateurs saisissent la même prompt, ils voient les réponses de deux modèles dont l’identité est masquée, puis votent pour choisir le meilleur résultat.
Le projet a été initialement lancé par LMSYS et des chercheurs de l’Université de Californie à Berkeley, avant de se développer en une plateforme indépendante. La marque officielle actuelle a été simplifiée en Arena ; l’ancienne page de blog de LMSYS n’est plus qu’un outil pour comprendre l’histoire et ne doit pas servir de point d’accès principal au produit.
La relation entre Chatbot Arena, LMArena et Arena
| Nom | Étapes et significations | Recommandations d'utilisation actuelles |
|---|---|---|
| Chatbot Arena | Nom du projet de recherche originale débutant en 2023 | Utilisé pour les thèses, les introductions historiques et les premiers codes open source |
| LMArena | Nom de la marque à l’étape du site indépendant et de l’entreprise | Encore largement utilisé par les médias et les utilisateurs |
| Arena | Marque unifiée actuelle | Privilégier le site officiel, les classements et les descriptions de produits |
| LMSYS | Organisation académique qui a lancé les recherches initiales | Ne peut pas être entièrement assimilé à l’entreprise Arena actuelle et à tous ses produits. |
Comment fonctionne Arena
- Sélectionnez du texte, des images, des vidéos, du code ou tout autre élément adapté à la tâche dans l’arène.
- Entrez une prompte réelle capable de distinguer les capacités du modèle.
- La plateforme propose aléatoirement deux modèles anonymes et génère les résultats en même temps.
- Comparer les deux côtés en termes de précision, du niveau d’aide, du style et du degré d’achèvement de la tâche.
- Choisir A est mieux, B est mieux, match nul ou les deux sont mauvais.
- Vérifiez l’identité réelle du modèle après avoir soumis le vote.
- Poursuivre la conversation ou lancer une nouvelle série, afin que les données de préférences soient intégrées au système d’évaluation publique.
Fonctionnalités clés
1. Combat de modèles anonymes
Le mode Battle cache le nom du modèle avant le vote, afin de réduire la notoriété de la marque et l’influence des préjugés des utilisateurs. La réponse elle-même peut néanmoins révéler le style du modèle ; par conséquent, le mécanisme d’anonymat ne peut que réduire les biais, sans pouvoir les éliminer complètement.
2. Préférences humaines en matière de vote
La plateforme ne repose pas sur des réponses standard fixes, mais laisse les utilisateurs réels juger quel résultat est le plus utile. Elle convient particulièrement à évaluer des tâches difficiles à mesurer par un seul score, telles que l’écriture, les dialogues, les images et la génération ouverte.
3. Classements par circuit
Arena est passé d’un chat de texte pur à des fonctionnalités incluant des images, des vidéos, du code, du contenu visuel et d’autres domaines spécialisés. Les entrées, les pools de modèles et les objectifs d’évaluation diffèrent selon les classements, ce qui rend impossible une comparaison directe entre eux.
4. Mode direct
En plus des combats anonymes, les utilisateurs peuvent également choisir directement des modèles connus pour les tester. Le mode Direct convient pour valider des modèles spécifiques, mais seuls les votes conformes aux règles d’évaluation anonyme doivent influencer le classement.
5. Recherche publique et ensembles de données
Arena publie des articles de recherche, des analyses et des ensembles de données sur les préférences humaines traitées, destinés à l’évaluation de modèles, aux attaques adversariales, au refus excessif et aux capacités de recherche. Les données publiques disposent de leur propre traitement de la vie privée et de licences, et ne peuvent pas être considérées comme des données brutes complètes de la plateforme.
Aperçu des fonctions principales
- Faire répondre deux modèles d’IA anonymes à la même question et les comparer côte à côte.
- Soutient les options de vote pour la victoire, le match nul et les deux autres.
- Révéler l’identité du modèle après le vote afin de réduire les biais envers la marque avant le vote.
- Fournit des classements de textes, d’images, de vidéos et de code mis à jour en continu.
- Voir les performances des modèles de manière plus détaillée par catégorie, langue ou tâche.
- Sélectionnez directement un modèle spécifique pour l’essayer et valider les résultats.
- Modèles de prévisualisation qui n’ont pas encore été officiellement publiés ou présentés sous un nom de code.
- Faire publics les données sur les préférences humaines, les articles et les méthodes d’évaluation.
- Les retours de la communauté sont rassemblés pour aider les développeurs de modèles à améliorer le produit.
Comment interpréter les scores du classement
Arena regroupe un grand nombre de relations de victoires/defaites en paires en une classement de capacité relative. La méthode actuelle utilise généralement des modèles statistiques de comparaison en paires tels que Bradley-Terry, combinés à une estimation de l’incertitude par rééchantillonnage. Les utilisateurs désignent souvent ces résultats sous le nom de score Elo, mais la méthode de calcul précise doit se fonder sur les indications fournies par le classement.
| Indicateur ou concept | Représente quoi | Ça ne dit rien. |
|---|---|---|
| Arena Score | Intensité de la préférence relative du modèle dans les données de vote actuelles | Ce n’est pas le taux de justesse absolu ni le score d’intelligence général. |
| Rank | Position selon la liste spécifiée et les règles de statistique | On ne peut pas garantir que ce sera nécessairement mieux dans un contexte professionnel réel. |
| Intervalle de confiance | Plage d’incertitude des classements et des scores | Lorsque les intervalles se chevauchent, il ne convient pas de souligner de petites différences de classement. |
| Nombre de votes | Taille d’échantillon de combat pouvant être utilisée pour l’estimation | Un grand nombre n’implique pas qu’échantillon soit sans biais. |
| Classement des listes | Performance relative du modèle pour une tâche ou une langue spécifique | On ne peut pas remplacer la tâche d’organiser ses propres tests. |
Comment concevoir des indications de contraste efficaces
- Choisissez un problème concret parmi vos tâches réelles, plutôt que de vous contenter de questions de bon sens.
- Fournir le contexte nécessaire, les données d’entrée, les contraintes et le format attendu pour la sortie.
- Évitez d’inclure des informations personnelles, des secrets commerciaux et des documents non publics.
- Faire effectuer la même tâche à deux modèles, sans changer les critères d’évaluation en cours de route.
- Vérifier d’abord de manière indépendante les faits, le raisonnement et le respect des instructions, puis comparer le style d’expression.
- Lorsqu’il est difficile de trancher, choisissez un match nul ou « les deux sont mauvais » ; il n’est pas nécessaire d’imposer une victoire ou une défaite.
- Reproduire plusieurs échantillons différents pour les tâches clés, sans se fier à un seul combat pour faire le choix.
À qui s’adresse-t-il
- Utilisateurs d’IA ordinaires souhaitant expérimenter différents modèles de pointe.
- Développeurs ayant besoin d’une comparaison initiale des compétences en rédaction de modèles, raisonnement, codage et capacités visuelles.
- Chercheurs en évaluation des biais humains et en méthodes de classement de modèles.
- Observateurs du secteur qui suivent la performance relative des nouveaux modèles et des modèles en prévisualisation.
- Équipe de produits et techniques externes nécessaires pour collecter des références afin de choisir le modèle.
- Les laboratoires et les fabricants qui souhaitent améliorer le modèle grâce aux retours des utilisateurs réels.
- Évaluateurs qui étudient les attaques sur les classements, les biais et la fiabilité statistique.
Différents arènes et scénarios d’utilisation
- Dialogue de texte : Comparaison des connaissances, du raisonnement, de la création et du respect des instructions.
- Code : comparaison de la génération de code, de la correction, de la mise en œuvre de l’interface et de l’utilisation d’outils.
- Image : Comparaison de la génération d’images à partir de texte, de l’édition et du respect des prompts.
- Vidéo : Comparer la qualité et la cohérence des vidéos générées à partir de textes ou d’images.
- Compréhension visuelle : questions-réponses sur des images, diagrammes, OCR et raisonnement multimodal.
- Recherche et étude : recherche comparative, citations, actualité et réponses synthétiques.
- Langue spécifique : Observer la préférence relative du modèle pour le chinois et d’autres langues.
Gratuit et exigences de compte
Arena propose au public un accès gratuit aux combats de modèles et aux classements, sans forfaits payants destinés aux utilisateurs ordinaires. Les différents modèles peuvent présenter des files d’attente, des débits limités, des restrictions géographiques, ainsi que des limitations liées à la connexion ou à l’utilisation quotidienne ; la plateforme peut également être ajustée en fonction de sa capacité.
| Fonctionnalité | Prix | Compte et restrictions |
|---|---|---|
| Voir le classement | Gratuit | Généralement, on peut le consulter directement |
| Combat de modèles anonymes | Gratuit | Il peut être nécessaire de se connecter et de faire face à des restrictions de vitesse ou de capacité. |
| Expérience du modèle Direct | Gratuit | Les modèles et le nombre d’essais disponibles peuvent varier |
| Ensemble de données de recherche | Ouvrir selon la page correspondante | Il faut respecter les conditions de licence et d’utilisation du jeu de données |
| Évaluation et collaboration avec les fabricants de modèles | Prix unifié non divulgué | Coordonné séparément par Arena et ses partenaires |
Comment utiliser correctement le classement pour choisir un modèle
- Choisissez d’abord la catégorie, la langue et le classement les plus proches de votre activité.
- Observez les scores et les intervalles de confiance, sans vous concentrer uniquement sur le premier et les petites différences de classement.
- Vérifier que la version du modèle dans le classement correspond à la version réellement disponible à l’achat.
- Filtrage en fonction des coûts, des délais, du contexte, de la politique de données et des modalités de déploiement.
- Créer un ensemble d’évaluation interne contenant des données de business réelles.
- Tester séparément les faits, le code, la sécurité, les appels d’outils et la sortie structurée.
- Surveiller en continu les mises à jour du modèle et les retours métier une fois en ligne.
Les avantages du classement
- L’utilisation de prompts ouverts avec des utilisateurs réels est plus proche de l’expérience quotidienne que les examens statiques.
- La présentation anonyme réduit certains biais de marque et l’influence de la réputation du modèle.
- Les comparaisons par paires permettent de juger plus facilement que les demandes d’attribuer des scores absolus.
- Les modèles et les votes sont mis à jour en continu, ce qui permet de refléter rapidement les performances des nouvelles versions.
- Couvre le texte, les images, les vidéos, le code et les compétitions multimodales.
- La publication des recherches, des méthodes et d’une partie des données favorise la révision externe.
- Permettre aux petits laboratoires et aux grands fabricants d’obtenir des avis des utilisateurs dans le même cadre.
Restrictions d'utilisation et biais méthodologiques
- Les votants et les mots-clés proviennent d’utilisateurs choisis librement et ne représentent pas tous les pays, secteurs et groupes de population.
- Les utilisateurs préfèrent peut-être des réponses plus longues, plus assurées ou plus stylées, plutôt que des réponses plus précises.
- Les modèles anonymes peuvent encore être identifiés à travers le choix des mots, le format et le style de refus de réponse.
- Le classement est un classement relatif ; les changements dans le pool de modèles et la distribution des combats affectent les scores.
- Une petite différence de classement peut ne pas avoir de signification statistique et doit être interprétée en conjonction avec les intervalles de confiance.
- La version de prévisualisation du modèle et la version publiée peuvent différer en termes d’indications, d’échantillonnage ou de configuration.
- Le vote malveillant, les attaques coordonnées et la pollution des données nécessitent une protection continue.
- Les préférences humaines générales ne peuvent pas remplacer l’évaluation en matière de santé, de droit, de sécurité et de tâches d’entreprise.
Confidentialité et soumission de contenu
Il est indiqué officiellement que les suggestions soumises par les utilisateurs seront collectées afin de soutenir une évaluation équitable et transparente, et qu’une partie des retours pourra être partagée avec les développeurs du modèle. Les utilisateurs doivent considérer Arena comme un environnement de recherche publique, et non comme un outil de messagerie privé pour traiter des données secrètes.
- Ne soumettez pas de nom, de coordonnées, de compte, de mot de passe ou d’informations d’identité.
- Ne collez pas de codes internes à l’entreprise, de données clients ou de documents non publics.
- Les images et vidéos ne peuvent utiliser que des matériaux que vous possédez ou pour lesquels vous avez une autorisation.
- Pour les problèmes liés à des secteurs sensibles, il convient d’utiliser des échantillons synthétiques ou désensibilisés.
- Vérifier avant le vote que la réponse ne divulgue pas de contenu sensible dans les entrées.
- Respectez les règles de filtrage de la vie privée, les licences et les règles de redistribution lors de l’utilisation de jeux de données publics.
Projets open source et ensembles de données
La version initiale de Chatbot Arena a été développée sur la base du projet LMSYS FastChat. FastChat est distribué sous la licence Apache-2.0 et offre des services multi-modèles, une interface web ainsi que du code lié à l’évaluation. Aujourd’hui, la plateforme Arena a développé davantage de catégories spécialisées et des capacités opérationnelles commerciales ; le dépôt initial ne peut donc pas représenter pleinement la version en ligne actuelle.
- FastChat comprend un service de modèles, une interface de dialogue et une première implémentation d’Arena.
- Arena publie des données de préférences humaines traitées sur des plateformes telles que Hugging Face.
- Des articles scientifiques connexes présentent le vote par paires anonyme et les méthodes de tri.
- La vision, la recherche, le rejet excessif et les attaques de classements font l’objet d’études spécialisées.
- Le code open source, les données de recherche et les plateformes en ligne sont trois domaines distincts.
- Le lien GitHub original de StableLM dans la base de données n’est pas lié au projet Arena et ne doit pas être considéré comme une source officielle.
Pourquoi ne peut-on pas se baser uniquement sur le classement d’Arena
- Les coûts d’exploitation et les retards ne sont pas pris en compte dans le score des préférences générales.
- Le hébergement des données, la vie privée, la conformité et les conditions fournisseurs doivent être évalués séparément.
- L’output structuré, les appels d’outils et la stabilité sur de longues périodes peuvent manquer d’échantillons suffisants.
- Le nombre de suggestions pour les sous-secteurs en chinois peut être inférieur à celui des tâches en anglais général.
- Après mise à jour du modèle, la version du classement peut temporairement ne pas correspondre à la version réelle de l’API.
- Les tâches à haut risque nécessitent encore plus des tests reproductibles et une vérification par des experts.
Plateforme et statut open source
| Projet | Situation actuelle |
|---|---|
| Nom actuel | Arena AI, anciennement nommé LMArena et Chatbot Arena |
| Forme du produit | Modèles de combat en ligne, expérience Direct et classements publics |
| Prix | La fonction publique est gratuite, il n’y a pas de forfaits payants pour les utilisateurs ordinaires. |
| API pour les développeurs | Aucune API de raisonnement de modèle unifié pour les utilisateurs ordinaires n’est fournie. |
| Projets open source initiaux | LMSYS FastChat, licence Apache-2.0 |
| Données publiques | Ensemble de données des préférences humaines après traitement et article de recherche |
| Est-ce entièrement open source | Non, la plateforme complète actuelle n’est pas équivalente au dépôt FastChat initial. |
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | Arena AI |
| Nom historique | LMArena, Chatbot Arena |
| Origine | Projet de recherche LMSYS et de l’Université de Californie à Berkeley |
| Type d’outil | Tests aveugles de modèles d’IA, classements et plateforme de tests des biais humains |
| Mécanisme central | Combats en duo anonymes et votes des utilisateurs |
| Modalité de couverture | Textes, images, vidéos, code et multimodalité |
| Modèle de prix | Gratuit |
| Fournir une API de raisonnement ? | Non |
| Est-ce open source | FastChat a été open source dans un premier temps ; la plateforme actuelle n’est pas entièrement open source. |
Indice de recommandation
4,7 / 5. Arena AI constitue une référence importante pour observer les préférences réelles des utilisateurs et l’expérience avec les modèles de pointe ; les combats anonymes et la recherche publique ont une valeur unique ; cependant, le classement ne correspond pas à un score objectif et complet, et le choix d’un modèle doit tenir compte des tâches internes, des coûts, de la sécurité et des exigences de déploiement.
Questions fréquentes
LMArena et Chatbot Arena, est-ce la même plateforme ?
Elles appartiennent à la même phase de développement du projet, et la marque actuelle est Arena. Chatbot Arena était le nom initial, tandis que LMArena en est une marque indépendante ultérieure.
Arena AI est-il gratuit ?
Les combats publics, l’expérience Direct et le classement sont actuellement gratuits, mais la disponibilité des modèles, les temps d’attente et le nombre d’utilisations peuvent varier en fonction de la capacité.
Puis-je voir le nom du modèle avant de voter ?
Le mode Battle n’est pas affiché ; l’identité est révélée seulement après soumission du vote. Le mode Direct permet aux utilisateurs de choisir directement des modèles connus.
Le premier de la classe est-il le meilleur modèle ?
Pas nécessairement. Le classement reflète les préférences relatives dans le cadre d’une distribution spécifique d’utilisateurs et de prompts ; le choix réel doit également prendre en compte la précision de la tâche, le coût, le délai, la confidentialité et le déploiement.
Arena propose-t-elle une API de modèles ?
Il n’existe pas d’API de raisonnement en production unifiée destinée aux développeurs ordinaires. Elle est principalement utilisée pour l’expérience, les matchs et l’évaluation, et non comme plateforme de mise en œuvre collective de modèles.
Arena est-il open source ?
Au début, FastChat et une partie des données de recherche étaient accessibles, mais actuellement, le site complet d’Arena, toutes les compétitions et le système opérationnel ne peuvent pas être considérés comme entièrement open source.
Outil similaire au classement de Chatbot Arena


 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164