




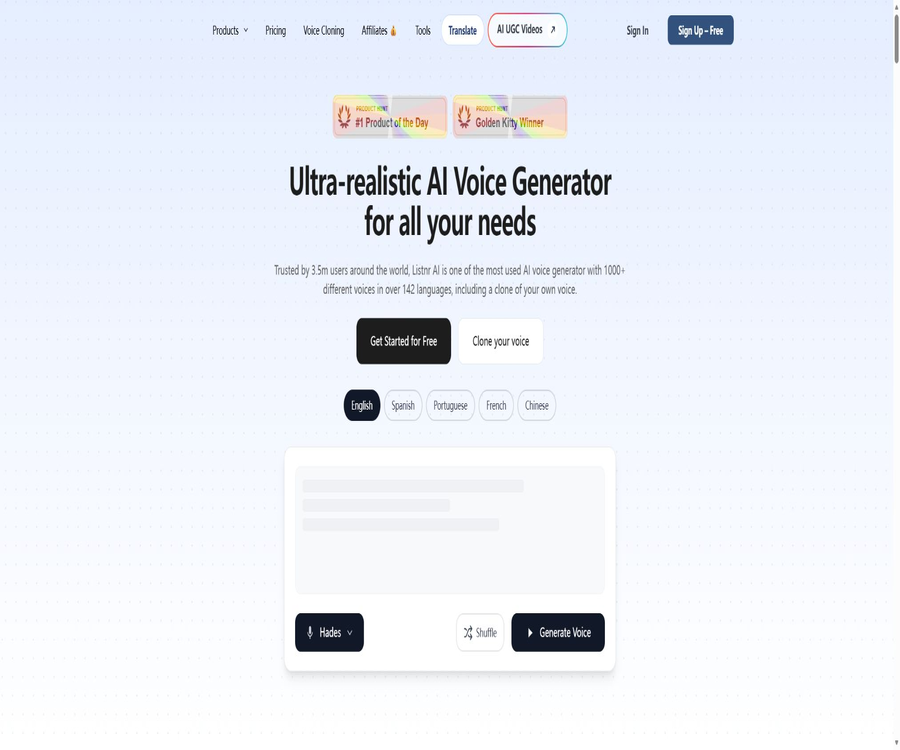
Listnr 2.0
Listnr 2.0 – ein intelligentes Tool für KI-gestütztes Audio
Tags:KI-Audio-ToolsWas ist Listnr 2.0?
Listnr 2.0 ist eine von Listnr Software Private Limited betriebene KI-gestützte Sprachgenerierungsplattform, die hauptsächlich Texte, Artikel oder PDF-Inhalte in synthetische Sprache umwandelt.
Es bietet gleichzeitig Sprachklonierung, Mehrsprachigkeitsbearbeitung, Podcast-Hosting, Video-Synchronisation sowie Entwickler-APIs und eignet sich für Nutzer, die Batch-Generierung von Kommentaren oder die Integration von Sprachfunktionen in ihre Produkte benötigen.
Hauptfunktionen
Text-zu-Stimme-Übersetzung und präzise Steuerung
- Nach dem Eingeben oder Einfügen von Text wählen Sie die Sprache, den Akzent und die Stimmlage aus, um eine vorab anhörbare Sprachaufnahme zu erzeugen, die anschließend als MP3- oder WAV-Audio exportiert werden kann.
- Man kann die Sprachgeschwindigkeit, die Tonhöhe, den Akzent, die Pausen sowie den emotionalen Ton anpassen. Mit SSML-Tags lassen sich zudem feinere Aspekte der Rhythmik und Aussprache steuern.
- Erstellen Sie eine benutzerdefinierte Aussprachentabelle, um die Aussprache von Markennamen, Personennamen oder Fachbegriffen zu speichern und sie in späteren Projekten wiederzuverwenden.
- Laut offiziellen Angaben stehen mehr als 1000 verschiedene Klangfarben zur Verfügung, die 142 Sprachen und Akzente abdecken; der tatsächliche Auswahlumfang kann je nach Paket und Konto variieren.
Mehrfachsprecher, Kloning und Inhaltsproduktion
- Durch die Zuweisung unterschiedlicher Klangfarben zu verschiedenen Abschnitten in derselben Audio-Engine können Interviews, dialogbasierte Podcasts, Lehrgespräche oder Stimmen für Spielcharaktere erstellt werden.
- Für die Klonierung von Stimmen müssen Sprachproben hochgeladen werden, um eine individuelle Stimmlage zu erzeugen, die für spätere Synthesen verwendet werden kann. Es können nur Stimmen von Sprechern verarbeitet werden, für die eine ausdrückliche Genehmigung vorliegt.
- Die Plattform ermöglicht die Verwendung von Texten und Kommentaren bei der Videoerstellung, außerdem kann sie Podcasts erstellen, hosten und verbreiten – ideal, um das Schreiben und Veröffentlichen in einem einzigen Workflow zu bündeln.
- Für Hörbücher, Kurse, Erklärungsvideos und Werbespots kann man zunächst Abschnitte voraus abspielen und anschließend das gesamte Projekt erstellen, um Verschwendung durch Aussprach- oder Rhythmusfehler zu vermeiden.
Eingabe, Ausgabe und Plattform
| Typ | Unterstützte Inhalte | Häufige Anwendungen | Hinweise |
|---|---|---|---|
| Text und SSML | Manuelle Eingabe, Einfügen von Texten, Markierungen mit Pausen und Betonungen | Synchronisation, Kurse, Hörbücher | Verschiedene Klangfarben können unterschiedliche Unterstützung für SSML-Eigenschaften bieten. |
| Artikel und PDF | Adresse des Artikels oder Adresse der PDF-Datei | Artikel in Audio umwandeln, Dokumente vorlesen | APIs benötigen zugängliche Ressourcen und verbrauchen Kontostunden. |
| Stimmproben | Aufnahme des autorisierten Sprechers | Klonierte Klangfarben, Markenstimmen | Stimmen gehören zu sensiblen biometrischen Daten und erfordern eine nachvollziehbare Einwilligung. |
| Audio und Video | Projekte zur Erstellung von synthetisierter Sprache, Transkription, Übersetzung oder Synchronisation | Podcasts, Untertitel, Mehrsprachige Lokalisierung | Die Erstellungszeit, der Speicherplatz sowie die Anzahl der Videos sind durch das Paket begrenzt. |
Derzeit ist die Nutzung über die Webversion möglich; es gibt bisher keine offiziellen Seiten für iOS, Android oder den Chrome Store für dieses KI-Produkt. Bevor man die gleichnamige App herunterlädt, sollte man die Identität des Entwicklers überprüfen.
Anleitung zur Verwendung
- Erstellen Sie ein Konto und gehen Sie zum Spracheditor. Wählen Sie zunächst den Stimmton entsprechend der Sprache des Inhalts, des Zielpublikums und des Verwendungszwecks aus.
- Kopieren oder importieren Sie den Text und teilen Sie ihn semantisch in Abschnitte auf; weisen Sie für die Dialogebenen jeweils unterschiedliche Sprecher zu.
- Legen Sie die Sprechgeschwindigkeit, Pausen, Betonung und Ausspracheregeln fest, überprüfen Sie zunächst einen Absatz im Voraus und bestätigen Sie die Aussprache von Namen und Fachbegriffen.
- Erstellen Sie ein vollständiges Audio-Datei, überprüfen Sie die Aussprache, die Stimmung sowie die Lautstärke, und exportieren Sie anschließend je nach weiteren Bearbeitungsanforderungen als MP3 oder WAV.
- Für öffentliche Veröffentlichungen oder kommerzielle Projekte sollte man erneut die kommerziellen Rechte des verwendeten Pakets, die Lizenzen für die Materialien sowie die notwendigen Angaben zu den zusammengestellten Inhalten überprüfen.
Passend für Nutzer und Szenarien
- Video-Ersteller: Erstellung von Untertiteln in großer Menge für Kurzvideos, Tutorials, Produktpräsentationen und Erklärungsinhalte.
- Podcast- und Verlagsteam: Erstellung von Mehrpersonengesprächen, Audioartikeln oder Hörbüchern unter Verwendung von Hosting- und Vertriebsfunktionen.
- Bildungs- und Unternehmensschulungsteams: Umwandlung von Lehrmaterialien in mehrsprachige Audiodateien zur Unterstützung des barrierefreien Lernens oder von Kursen überregionaler Art.
- Entwickler und Produktteams: Erstellung von Sprache über APIs, Abruf verfügbarer Stimmen, Abfragen asynchrone Aufgaben oder Rückgabe von Wort-für-Wort-Timestamps.
Preispakete
| Paket oder Version | Preis | Abrechnungszeitraum | Kernrechte oder -beträge | Für Nutzer geeignet |
|---|---|---|---|---|
| Individual | $190 | Jahresbeitrag | 20.000 Punkte pro Monat – das entspricht etwa 2 Stunden Sprachnachrichten sowie 50 GB Speicherplatz. Zudem sind 50 Videos pro Monat verfügbar. | Einzelne Ersteller |
| Solo | $390 | Jahresbeitrag | 50.000 Punkte pro Monat – das entspricht etwa 5 Stunden Sprachnutzung sowie 100 GB Speicherplatz. Zudem gibt es 150 Videos pro Monat. | Kreative oder kleine Teams |
| Agency | $990 | Jahresbeitrag | 250.000 Punkte pro Monat – das entspricht etwa 25 Stunden Sprachnachrichten sowie 250 GB Speicherplatz. Zudem sind 250 Videos pro Monat verfügbar. | Kleine und mittlere Unternehmen sowie Agenturteams |
Alle drei jährlichen Pakete umfassen alle Klangfarben, unbegrenzte Exportmöglichkeiten, unbegrenztes Einbetten von Audiodateien sowie kommerzielle Nutzungsrechte. Allerdings gibt es klare Obergrenzen für die Länge der Sprachaufnahmen, die Anzahl der Punkte sowie die Menge an gespeicherten Videos.
Der Registrierungsvorgang kann kostenlos beginnen, doch aktuell sind keine festen Informationen zu einem kostenlosen Datenvolumen verfügbar. Falls Monatsabos, Punktesysteme oder regionale Zahlungsoptionen im Konto angezeigt werden, gelten die Angaben auf der jeweiligen Zahlelseite.
Rückerstattung und Stornierung
- Die Abbestellung verhindert lediglich die Abbuchung im nächsten Zeitraum; die bereits gezahlten Gebühren werden nicht automatisch zurückerstattet.
- Für Nutzer außerhalb der EU, des Vereinigten Königreichs oder Indiens ist ein vollständiger Rückerstattungsbetrag innerhalb von 7 Tagen nach dem ersten Kauf möglich. Dabei darf die Gesamtlänge des Inhalts 1000 Wörter oder 5 Minuten Audio nicht überschreiten – dies wird jedoch nach Ermessen entschieden.
- Lebenslange Angebote sind grundsätzlich nicht erstattungsfähig; Nutzer in der EU, im Vereinigten Königreich und in Indien unterliegen zudem den örtlichen Verbraucherschutzvorschriften.
API und Open-Source-Status
- Erstellen Sie im Account-Backend eine API-Schlüssel und lagern Sie diesen ausschließlich sicher auf der Serverseite auf – integrieren Sie ihn nicht in die Frontend- oder öffentlichen Codeabschnitte.
- Beim Aufruf der Text-zu-Stimme-Schnittstelle werden die Stimmlageangabe, der SSML-Text sowie optionaler Stil, Sprechtempo, Format und Abtastrate übergeben.
- Für lange Inhalte können asynchrone Aufgaben verwendet werden, wobei die Kennung der zurückgegebenen Aufgabe gespeichert wird, um anschließend den Verarbeitungsstatus sowie das endgültige Audioresultat abzufragen.
- Wenn eine Ausrichtung der Untertitel erforderlich ist, können Zeitstempel für jedes Wort angefordert werden; außerdem kann eine Liste der Tonfarben abgerufen werden oder eine fließende Sprach-Schnittstelle mit geklonten Tonfarben verwendet werden.
Die Entwicklerdokumentationen und Beispiele für Anfragen sind im Team-Code-Repository verfügbar, doch das Repository gibt keine Angaben zur Softwarelizenz. Daher sollte es nicht als ein Open-Source-SDK angesehen werden, das frei wiederverwendet werden kann.
Die Listnr-Plattform, die zugrunde liegenden Modelle sowie der Servicecode gehören zu proprietärem Softwarematerial; offizielle API-Dokumentationen und Beispiele bedeuten nicht, dass das Produkt selbst open source ist.
Privatsphäre, Urheberrechte und Sicherheit
- Konten, Geräte, Nutzungstagebücher, Zahlungstoken sowie hochgeladene Texte, Audiodateien, Videodateien und Tonproben werden je nach Bedarf des Services verarbeitet. Die ursprünglichen Audiodateien werden standardmäßig 30 Tage lang aufbewahrt und danach gelöscht oder anonymisiert.
- Die Plattform erklärt, dass sie keine personenbezogenen Daten verkauft oder vermietet und Rechte bzw. Einstellungen zur Einsicht, Korrektur, Löschung, Exportierung sowie zum Austritt bietet.
- Was die Nutzung zur Trainierung betrifft, so besagen die Sicherheitsanweisungen, dass die Daten nicht für das Training verwendet werden. Die Bedingungen erlauben es hingegen, Sprachdaten mit ausdrücklicher Zustimmung außerhalb von Konversationen zur Modelltrainierung zu nutzen, und es steht ein Austrittsschalter zur Verfügung.
- Der Benutzer behält das Recht auf die Eingabe von Inhalten. Die Plattform überträgt im Rahmen des gesetzlich Zulässigen das Recht an den erzeugten Ergebnissen an den Benutzer, garantiert jedoch nicht, dass diese Ergebnisse einzigartig sind oder keine Rechte Dritter verletzen.
- Das Klonen der Stimme eines anderen ohne Zustimmung ist verboten, ebenso wie Urheberrechtsverletzungen, Betrug, Hass, Belästigung, irreführende Deepfakes sowie Inhalte, die erheblichen Schaden verursachen können.
Vorteile und Einschränkungen bei der Verwendung
Hauptvorteile
- In einer Bearbeitungsumgebung, die mehrsprachige Stimmen, Mehrpersonendialoge, ein Aussprachewörterbuch, Podcast-Hosting und APIs vereint, können verschiedene Prozesse vom Entwurf bis zur Bereitstellung abgedeckt werden.
- Es unterstützt die Audio-Voransicht, die Exportierung in MP3- und WAV-Format, asynchrone Aufgaben sowie Wort für Wort Zeitstempel. Es kann sowohl zur direkten Erstellung von Inhalten als auch für die programmierte Produktion verwendet werden.
Verwendung von Grenzen
- Die Natürlichkeit des Klanges, die Art der Aussprache sowie die emotionale Wirkung variieren je nach Sprache, Klangfarbe, Script und Parametern. Vor einer professionellen Veröffentlichung ist eine manuelle Überprüfung erforderlich.
- Künstlich erzeugte Sprache kann den vorhandenen Stimmen oder den Ergebnissen anderer Nutzer ähneln. Geschäftskunden müssen selbst prüfen, ob die Texte, Persönlichkeitsrechte, Markenzeichen, Audiomaterialien sowie die Regeln bezüglich der Veröffentlichungsmöglichkeiten geeignet sind.
- Auch bei der jährlichen Abonnementvariante gelten weiterhin Beschränkungen bezüglich der Punkte pro Monat, der Dauer der Sprachgespräche sowie der Menge an gespeicherten Daten und Videos. Zudem kann die API zu Limits oder einem unzureichenden Datenvolumen führen.
- Bei Beträgen, Limits, Zahlungsfristen, Rückerstattungen oder Einstellungen gelten die tatsächliche Abrechnungsseite, der Account-Backend sowie die aktuellen Bedingungen.
Zusammenfassung
Listnr 2.0 eignet sich für Einzelpersonen und Teams, die mehrsprachige Sprachgenerierung, Klonen von Stimmen, Podcasts sowie API-Integrationen in denselben Inhaltsproduktionsprozess integrieren möchten.
Bevor man ein Paket auswählt, sollte man zunächst die Klangqualität in der eigenen Sprache und mit dem eigenen Skript testen sowie die monatliche Gebühr, die kommerziellen Vorteile, die Lizenzen für die Nutzung der Stimme sowie die Einstellungen zur Datenausbildung überprüfen.
Tools, die dem Listnr 2.0 ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164