




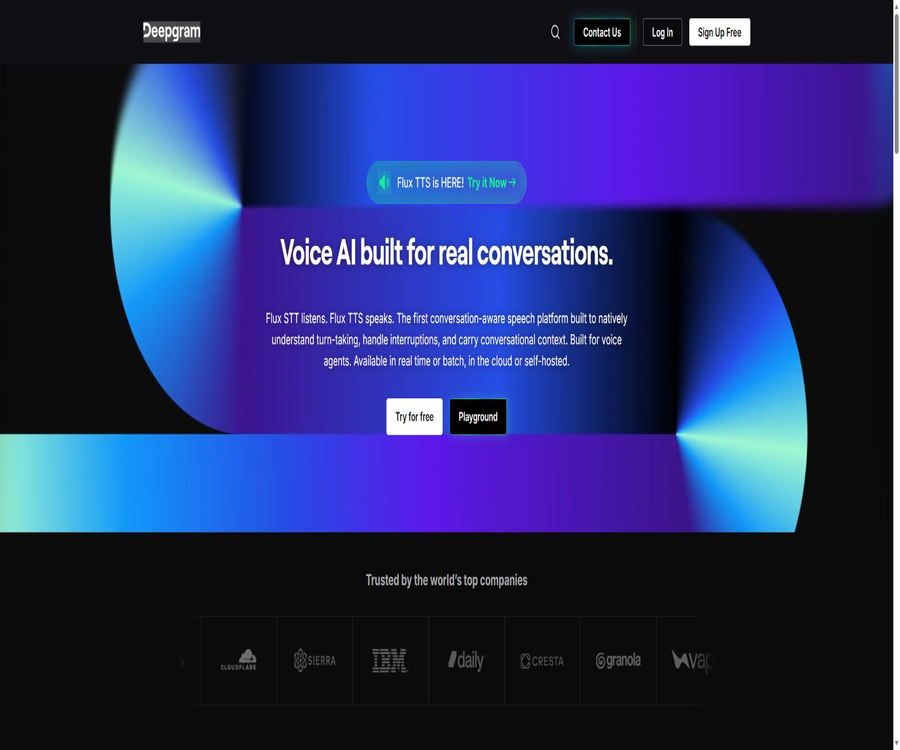
Deepgram
Deepgram – ein intelligentes Tool für KI-gestütztes Audio
Tags:KI-Audio-ToolsEine kurze Beschreibung
Deepgram ist eine Sprach-KI-Plattform für Entwickler und Unternehmen, die über APIs Echtzeit- sowie Batch-Spracherkennung, dialogbasierte Sprachsynthese, umfassende Voice-Agent-Orchestrierung sowie Audioverständnis bietet und sowohl Cloud-Hosting, dedizierte Umgebungen als auch lokale Implementierungen unterstützt.
Einführung in die Tools
Deepgram bietet für echte Sprachanwendungen umfassende Funktionen – von dem Zuhören über das Denken bis hin zum Sprechen. Entwickler können entweder Speech-to-Text oder Text-to-Speech einzeln nutzen, oder sie können mithilfe einer WebSocket-Verbindung ein Echtzeit-Sprachsystem erstellen, das Unterbrechungen, Abwechslungen sowie Aufrufe von Tools verarbeiten kann.
Zu den aktuellen Kernmodellen gehören Nova-3 für die allgemeine Transkription, Flux STT für Dialogrunden, das dialogbasierte Flux TTS sowie die Aura-Serie zur Sprachsynthese. Die Produkte und Modelle sind kommerzielle Dienste; die Offenlegung des offiziellen SDK bedeutet nicht, dass die Gewichte der Modelle oder die Quellcodes der Plattform veröffentlicht werden.
Überblick über die Produktfähigkeiten
| Produkte | Haupteingabe | Hauptausgabe | Typische Anwendungen |
|---|---|---|---|
| Speech-to-Text | Echtzeit-Stream oder Aufnahmefail | Text mit Zeit, Sprecher und Zuverlässigkeit | Transkription, Untertitel und Analyse |
| Text-to-Speech | Text und Dialogkontext | Fließende synthetisierte Sprache | Kundenservice, Assistenten und Telefonroboter |
| Voice Agent API | Zweiwege-Realtime-Audio und Konfiguration | Unterbrochene Sprachgespräche | Kundenservice, Terminvereinbarung und Auslandsanrufe |
| Audio Intelligence | Audio-Transkription oder Text | Zusammenfassung, Thema, Stimmung und Absicht | Qualitätskontrolle, Erkenntnisse und Routing |
| Self-Hosted | Unternehmens-GPU-Infrastruktur | Privater Sprach-Infersions-Endpunkt | Datenverweil und niedrige Verzögerung |
| Playground | Mikrofon, Datei oder Text | Ergebnisse der Modell-Testung | Prototyp-Validierung und Parametervergleich |
Spracherkennungsmodelle
Nova-3
Nova-3 ist das derzeit empfohlene, allgemein einsetzbare Spracherkennungsmodell für die Produktion – es kann für Echtzeitstreams sowie voraufgenommenes Audio verwendet werden. Es unterstützt mehrere Sprachen, die automatische Spracherkennung sowie Geräusche und Audio aus weiterer Entfernung. Zudem kann die Erkennung von Marken-, Produkt- und Branchenterminen durch Keyterm Prompting verbessert werden.
Flux STT
Flux STT ist speziell für Echtzeit-Voice-Agenten konzipiert. Er erkennt nicht nur Texte, sondern integriert auch die Erkennung des Ende einer Sprechrunde sowie einen anpassbaren Dialogrhythmus in das Modell. Die englische Version und die mehrsprachige Version werden getrennt berechnet; bei der mehrsprachigen Version können Sprachanweisungen die Erkennung beeinflussen.
Nova-3 Medical und maßgeschneiderte Modelle
Nova-3 bietet Optionen für medizinisches Vokabular. Unternehmen können außerdem Kontakt zu den Vertriebsmitarbeitern aufnehmen, um Custom-Modelle anzufordern, die an spezifische oder besondere Daten angepasst werden. Professionelle Modelle müssen weiterhin anhand echter Akzente, Geräte, Szenarien und Wortsammlungen bewertet werden – es reicht nicht aus, sich nur auf allgemeine Benchmarks zu stützen.
Whisper Cloud im Vergleich zu den alten Modellen
Deepgram bietet weiterhin die Verwaltung von Whisper Large an und behält Nova-2, Enhanced und Base für bestehende Implementierungen bei. Für neue Projekte sollte man in der Regel zunächst Nova-3 mit Flux vergleichen, um zu vermeiden, aus Gründen der Kompatibilität standardmäßig das weniger skalierbare Whisper zu verwenden.
Spracherkennungsfunktion
- Streaming wird für die Echtzeit-Teiltranskription von Telefonaten, Meetings und Voice Agents verwendet.
- Pre-Recorded wird verwendet, um Aufnahmen hochzuladen und einen vollständigen Text asynchron oder synchron zu erzeugen.
- Speaker Diarization erkennt mehrere Personen und kennzeichnet an, wer jeden Abschnitt spricht.
- Smart Formatting kümmert sich automatisch um Satzzeichen, Groß- und Kleinschreibung, Datumsangaben und Währungen.
- Keyterm Prompting verbessert die Erkennung von Produktnamen, Abkürzungen und Fachbegriffen.
- Redaktion dient dazu, bestimmte sensible persönliche Informationen zu erkennen und zu entfernen.
- Entity Detection extrahiert Entitäten wie Personen, Organisationen, Orte und Daten.
- Die automatische Spracherkennung unterstützt die Verarbeitung von Sprachen, die unbekannt sind, oder bei Wechseln der Szenarioart.
Text-zu-Stimme-Sprachsynthese
Flux TTS
Flux TTS ist ein fließender, für dialogbasierte Sprachintelligenzen konzipierter Modelltyp, der den Tonfall, Rhythmus und die Stimmung durch den Kontext über mehrere Gesprächsrunden hinweg aufrechterhält. Er kann den Nutzer darüber informieren, was er vor einer Unterbrechung tatsächlich gehört hat, und es ist möglich, die Geschwindigkeit sowie den Stil ohne Unterbrechung des Gesprächs anzupassen.
Aura-2
Aura-2 ist für professionelle, großskalige und verzögerungsfreie Sprachsynthese konzipiert und kann in Kundenservice-, Benachrichtigungs- und Dialoganwendungen eingesetzt werden. Die bestehenden Aura-2-Modelle müssen aufgrund der Veröffentlichung von Flux TTS nicht umgestellt werden.
Aura-1
Aura-1 steht weiterhin als kostengünstige Option für die Sprachsynthese zur Verfügung. Bei der Auswahl sollten Sprache, Stimme, Verzögerung, die Aussprache strukturierter Inhalte sowie der Einsatzbereich berücksichtigt werden – und nicht nur der Preis pro tausend Zeichen.
Dialogbasierte Sprachsteuerung
Deepgram gestaltet die Sprachsynthese derzeit als Teil einer Dialogarchitektur, die den Zustand, die Grenzen der Sprechabschnitte sowie Unterbrechungen verfolgen kann. Für Projekte mit strengen Anforderungen an die Markenstimme oder an die Stimmenklonierung sollte man zunächst die aktuellen Modelle sowie die damit verbundenen Möglichkeiten überprüfen.
Voice Agent API
Die Voice Agent API vereint Spracherkennung, LLM-Orchestrierung und Sprachsynthese in einer Echtzeitverbindung, wodurch Entwickler nicht mehr gezwungen sind, mehrere Dienste zusammenzusetzen. Nutzer können auch ihre eigenen LLMs oder TTS-Systeme verwenden und lediglich die weiteren Sprach- und Orchestrierungsfunktionen von Deepgram nutzen.
- Integrierte Barge-in-Erkennung, die es Benutzern ermöglicht, den Agenten natürlich zu unterbrechen.
- Die Abwechselungsprognose hilft dem System dabei, zu entscheiden, wann zuzuhören, nachzudenken und zu sprechen.
- Funktionaufrufe ermöglichen es, im Dialog in Geschäftssysteme nachzufragen oder Tools auszuführen.
- Die Zwischensitzungssteuerung ermöglicht es, während der Sitzung Konfigurationen und Verhaltensweisen anzupassen.
- Wiederverwendbare Konfigurationen erleichtern die Wiederverwendung von Agenteneinstellungen.
- Die Multi-Agent-Architektur unterstützt den Austausch zwischen spezialisierten Agenten.
- Die Telephoniefunktion dient zum Zugang zum Netzwerk für eingehende und ausgehende Anrufe.
- Das Browser Agent SDK ermöglicht es, Echtzeit-Sprachfunktionen in Webanwendungen einzubinden.
Audio Intelligence
Audio Intelligence wird verwendet, um auf der Grundlage der Transkription strukturierte Ergebnisse wie Zusammenfassungen, Themen, Emotionen und Absichten zu erzeugen. Einige Funktionen werden je nach Eingangs- und Ausgabetoken extra berechnet und dürfen nicht als vollständig im Preis der Spracherkennung enthalten angesehen werden.
| Fähigkeiten | Ergebnis | Passende Szenarien | Hauptrisiken |
|---|---|---|---|
| Summarization | Zusammenfassung des Dialogs | Kundenservice-Protokolle, Meeting-Zusammenfassungen | Möglicherweise wurden Einschränkungen übersehen. |
| Topic Detection | Thementags | Inhaltsklassifizierung und Routing | Unstabile Mehrthemen-Grenzen |
| Sentiment Analysis | Emotionale Neigungen | Dienstleistungsqualitätskontrolle und Trends | Kontext, Kultur und ironische Abweichungen |
| Intent Recognition | Benutzerabsicht | Automatische Umleitung und anschließende Aktionen | Falsche Absichten können falsche Abläufe auslösen. |
| Entity Detection | Personen, Organisationen, Orte und Daten | CRM-Eingabe und -Auskunft | Die Schreibweise der Eigennamen muss überprüft werden. |
| Redaction | Entfernen von Teilen des sensiblen Textes | Datenschutz und konforme Verarbeitung | Kann die vollständige Datensicherheit gegen Lecks nicht ersetzen. |
Vollständiger Anmeldeprozess
- Erstellen Sie ein Deepgram-Konto und ein Projekt, um einen kostenlosen Kreditrahmen zu erhalten.
- Erstellen Sie eine API-Schlüssel, der nur die notwendigen Berechtigungen besitzt, und speichern Sie ihn in einer sicheren Serverkonfiguration.
- Wählen Sie je nach Echtzeit-Dialog oder Aufnahmeverarbeitung Streaming oder Vorab aufgezeichnet.
- Wählen Sie Nova-3, Flux oder andere Modelle, die für die Sprache und den Kontext geeignet sind.
- Einstellen von Audio-Kodierung, Abtastfrequenz, Sprache, Sprecher und Formatierungsparametern.
- Führen Sie Benchmarks mit echten Geräten, Störgeräuschen, Akzenten und Fachbegriffen durch.
- Temporäre Abschnitte, endgültige Abschnitte, Fehler, Zeitüberschreitungen und Neuanbindungen in den Verarbeitungsergebnissen.
- Die Länge des Audios, die Anzahl der Zeichen, zusätzliche Funktionen sowie die Konkurrenz gleichzeitig werden aufgezeichnet, um die Kosten zu überwachen.
- Konfigurieren Sie vor dem Go-Live Datenschutz, Archivierung, Regionen, Quoten und Strategien zur Fehlerbewältigung.
Lehrvideo zur Echtzeit-Transkription
- Stabiles Mono- oder Mehrkanal-Audio aus Browsern, Telefonen oder Audio-Geräten abrufen.
- Eine WebSocket-Verbindung herstellen und auf der Serverseite eine kurzfristige oder langfristige Authentifizierung mit Anmeldeinformationen durchführen.
- Geben Sie die korrekte Kodierung, die Abtastfrequenz und die Anzahl der Kanäle an, um zu vermeiden, dass das Audio falsch interpretiert wird.
- Verwenden Sie Nova-3 zur Verarbeitung der allgemeinen Transkriptionen oder Flux für die Verarbeitung der Dialogrunden.
- Aktivieren Sie Smart Formatting, Diarization und Keyterm nach Bedarf.
- Die Zwischenergebnisse werden für die Echtzeitoberfläche verwendet, die Endresultate für die Persistenz und Geschäftsaktionen.
- Ein Zustandsautomat für Netzwerkunterbrechungen, Stille, lange Pausen, Neuanbindung und Wiederholung von Abschnitten.
- Berechnen Sie die Wortfehlerrate, die Genauigkeit bei Entitäten und die End-zu-End-Latenz mit einem manuell annotierten Datensatz.
Leitfaden zur Erstellung eines Voice Agents
- Definieren Sie die Aufgaben des Agenten, die ausführbaren Aktionen sowie die Bedingungen, unter denen eine Übertragung an einen Menschen erforderlich ist.
- Konfigurieren Sie die Spracherkennung von Flux oder Nova, Anbieter für LLMs sowie TTS-Stimmen.
- Erstellen Sie Systemhinweise, um Identität, Tätigkeitsbereich und nicht zugesagte Leistungen einzuschränken.
- Führen Sie die Funktionsaufrufe aus und überprüfen Sie auf der Serverseite Parameter, Berechtigungen sowie die Idempotenz.
- Testen von Unterbrechungen durch Nutzer, Stille, Wiederholungen, Hintergrundgeräuschen und gleichzeitiges Sprechen.
- Protokollieren Sie, was der Benutzer tatsächlich hört, um eine Inkonsistenz im nachfolgenden Betriebszustand zu vermeiden.
- Für sensible Vorgänge werden Authentifizierungsverfahren, Bestätigungsschritte und manuelle Übernahme hinzugefügt.
- Überwachen Sie Dauer jeder Anruf, Verzögerung, Prozentsatz der Weiterleitung an einen Menschen, Erfolgsrate der Aufgaben und Kosten.
Bewertung der Produktqualität
- Ein Testset bereitstellen, das die wichtigsten Sprachen, Akzente, Geräte, Störgeräusche und Fachbegriffe abdeckt.
- Es werden zuverlässige Referenztranskripte manuell erstellt, und die Bewertungskriterien werden festgelegt.
- Testen Sie jeweils den Echtzeit- und den Batch-Modus getrennt voneinander, ohne Verzögerungen und Genauigkeitswerte zu vergleichen.
- Vergleich von Nova-3 einsprachig, mehrsprachig, Flux und bestehenden Anbietern.
- Wichtigen Entitäten wie Zahlen, Namen, Adressen, Medikamenten und Kontonummern wird eine eigene Punktzahl zugewiesen.
- Bewertung der Runden außerhalb der Wortfehlerrate, Verzögerung beim ersten Zeichen und endgültige Verzögerung.
- Schätzen Sie die Kosten für mehrkanalige Audioverarbeitung, zusätzliche Funktionen, Audio-Intelligenz sowie Wiederholungsversuche.
- Der Datenverkehr wird nur erweitert, wenn der Geschäfts-Threshold erreicht ist.
Für welche Benutzer geeignet
- Entwicklerteam für Voice Agents: Erstellung von Echtzeit-Stimmenassistenten mit niedriger Verzögerung und Unterbrechungsmöglichkeit.
- Callcenter-Plattform: Transkription von Anrufen, Zusammenfassung der Gespräche und Erkennung der Absichten.
- Konferenzen und Untertiteldienste: Erstellung von Echtzeit-Untertiteln, Sprechern und Kapiteln.
- Medizinische und Finanzunternehmen: Nutzung von Konformitätslösungen sowie privater Implementierungen durch Unternehmensverträge.
- Medien- und Podcast-Plattformen: Massen-Transkription, Suche und Verständnis von Aufnahmen.
- Vertrieb- und Kundenservice-Team: Konvertiert Sprachdaten in CRM- und Qualitätskontrollinformationen.
- Plattform-Entwicklerteam: Integration mit SDKs, regionalen Endpunkten und Self-Hosting.
Typische Anwendungsszenarien
| Szene | Empfehlungsfähigkeit | Schlüsselfaktoren | Risikokontrolle |
|---|---|---|---|
| Echtzeit-Kundenservice-Roboter | Flux STT plus Flux TTS oder Voice Agent | Unterbrechungen, Verzögerungen, Lösungsrate | Auf Menschliche Bearbeitung und Authentifizierung umleiten |
| Konferenzuntertitel | Nova-3 Streaming plus Diarisation | Wortfehlerrate und Sprechergenauigkeit | Die Teilnehmer stimmen zu |
| Aufnahmen archivieren | Nova-3 Pre-Recorded | Durchsatz, Kosten und Abrufrate | Sicherung und Zugriffskontrolle |
| Medizinische Unterlagen | Nova-3 Medical plus Redaktion | Begriffe und Schlüsselentitäten | BAA und manuelle Überprüfung |
| Telefonqualitätskontrolle | STT plus Audio Intelligence | Zusammenfassung, Emotionen und Absichten | Vermeiden Sie es, nur aufgrund von Emotionsbewertungen zu bestrafen. |
| Sprachbenachrichtigung | Aura-2 oder Aura-1 | Artikulation, Verzögerung und Kosten | Marken und Barrierefreiheitsprüfung |
| Lokale Sprachplattform | Self-Hosted | Datenverweilung und Kapazität | GPU, Aufrüstungen und Lizenzverwaltung |
Preisplanung
Die unten angegebenen Preise wurden am 22. August 2026 auf der offiziellen Website überprüft. Ein Teil der Preise für die Spracherkennungsdienste gilt als zeitlich begrenzte Aktion. Die Rabatte für Flux TTS und Voice Agent, die von Flux TTS bereitgestellt werden, laufen am 12. September 2026 aus. Daher muss man die Preise vor dem Einsatz erneut überprüfen.
| Planung | Preis oder Einstiegshürde | Hauptanteile | Standardgröße | Für Nutzer geeignet |
|---|---|---|---|---|
| Free Credit | Neukonto 200 Dollar | Keine Kreditkarte erforderlich, keine feste Fälligkeitsdatum für die Kreditlinie | Verwendung von öffentlichen Modellen | Prototyp und Bewertung |
| Pay As You Go | Nach tatsächlichem Verbrauch | Keine Mindestverpflichtung | STT-Stream: Bis zu 150 Konkurrenzen gleichzeitig | Entwickler und Start-up-Teams |
| Growth | Jährlich eine Anzahlung von mindestens 4.000 US-Dollar | Maximal bis zu 20% Rabatt sowie höhere Konkurrenzfähigkeit | STT-Stream: Bis zu 225 Konkurrenzen gleichzeitig | Wachsende Anwendungen in der Produktion |
| Enterprise | Kontaktieren Sie den Verkauf | Großskalige, maßgeschneiderte Modelle, private Bereitstellung und Support | Maßgeschneiderte Konkurrenz und SLA | Große oder regulierte Unternehmen |
Sprach-zu-Text-Preis
Echtzeit-Stimmerkennung beim Streamen
| Modell | Pay As You Go | Growth | Abrechnungseinheit | Anmerkungen |
|---|---|---|---|---|
| Flux English | Der aktuelle Wert beträgt 0,0065 US-Dollar. | Derzeit 0,0057 US-Dollar | pro Minute | Fließende Rabattpreise |
| Flux Multilingual | 0,0078 US-Dollar | 0,0068 US-Dollar | pro Minute | Unterstützung für mehrsprachigen Dialog |
| Nova-3 Monolingual | Derzeit 0,0048 US-Dollar | Derzeit 0,0042 US-Dollar | pro Minute | Fließende Rabattpreise |
| Nova-3 Multilingual | Derzeit 0,0058 US-Dollar | Derzeit 0,0050 US-Dollar | pro Minute | Fließende Rabattpreise |
| Custom | Kontaktieren Sie den Verkauf | Kontaktieren Sie den Verkauf | Vertrag | Eigene oder spezielle Daten |
Erkennung von vorab aufgenommenen Audiodaten
| Modell | Pay As You Go | Growth | Abrechnungseinheit | Für Aufgaben geeignet |
|---|---|---|---|---|
| Nova-3 Monolingual | 0,0043 US-Dollar | 0,0036 US-Dollar | pro Minute | Monolinguale Aufnahme |
| Nova-3 Multilingual | 0,0052 US-Dollar | 0,0043 US-Dollar | pro Minute | Mehrsprachige Aufnahmen |
| Whisper Large | 0,0048 US-Dollar | 0,0048 US-Dollar | pro Minute | Kompatibel mit bestimmten Whisper-Prozessen |
| Custom | Kontaktieren Sie den Verkauf | Kontaktieren Sie den Verkauf | Vertrag | Maßgeschneiderte Modelle |
Erweiterung Sprache-zu-Text
| Funktionen | Pay As You Go | Growth | Echtzeit oder aufgezeichnet | Anmerkungen |
|---|---|---|---|---|
| Redaction | 0,0020 US-Dollar pro Minute | 0,0017 US-Dollar pro Minute | Beides | Entfernen von Teilen sensibler Informationen |
| Keyterm Prompting | 0,0013 US-Dollar pro Minute | 0,0012 US-Dollar pro Minute | Beides | Stärkung von Schlüsselbegriffen |
| Smart Formatting | Enthält | Enthält | Beides | Satzzeichen und Formatierung |
| Entity Detection | 0,0017 US-Dollar pro Minute | 0,0017 US-Dollar pro Minute | Beides | Entfernen von Entitäten |
| Speaker Diarization | Echtzeit: 0,0020 US-Dollar pro Minute | Nach Seite richten. | Echtzeit | Der Aufnahmemodus umfasst derzeit |
| Speaker Diarization | Enthält | Enthält | Aufnahme | Mehrfach-Anmerkungen |
Text-zu-Sprache-Preise
Flux TTS ist bis zum 12. September 2026 zeitlich begrenzt kostenlos, ab dem 13. September 2026 wird wieder die normale Gebührenstruktur angewandt. Die kostenlose Periode ist kein dauerhaftes kostenloses Angebot.
| Modell | Pay As You Go | Growth | Abrechnungseinheit | Preisstatus |
|---|---|---|---|---|
| Flux TTS | Bis zum 12. September kostenlos, danach 0,0450 US-Dollar | Bis zum 12. September kostenlos, danach 0,0405 US-Dollar | Jede 1000 Zeichen | Aktion mit Zeitlimit |
| Aura-2 | 0,030 US-Dollar | 0,027 US-Dollar | Jede 1000 Zeichen | Der aktuelle Standardpreis |
| Aura-1 | 0,0150 US-Dollar | 0,0135 US-Dollar | Jede 1000 Zeichen | Der aktuelle Standardpreis |
Preise für die Voice Agent API
Voice Agent wird nach der Dauer des Gesprächs abgerechnet, wobei zwischen den Versionen unterschieden wird, die über LLMs und TTS von Deepgram verfügen oder nicht. Im Folgenden sind die aktuellen Preise während der kostenlosen Aktion für Flux TTS sowie die regulären Preise nach Ablauf der Aktion aufgeführt.
| Ebene | Aktueller Preis für Pay As You Go | Preis nach der Veranstaltung | Aktueller Preis von Growth | Eignet sich zur Konfiguration |
|---|---|---|---|---|
| Standard | 0,056 US-Dollar pro Minute | 0,075 US-Dollar pro Minute | 0,051 US-Dollar pro Minute | Verwenden Sie den vollen Standard-Sprachstack. |
| Standard BYO TTS | 0,065 US-Dollar pro Minute | Genau wie im Moment | 0,051 US-Dollar pro Minute | Eigene Sprachsynthese |
| Custom BYO LLM | 0,050 US-Dollar pro Minute | 0,065 US-Dollar pro Minute | 0,041 US-Dollar pro Minute | Eigener Sprachmodell |
| Maßgeschneidertes BYO LLM mit TTS | 0,050 US-Dollar pro Minute | Genau wie im Moment | 0,041 US-Dollar pro Minute | Eigener Sprachmodell und Sprachsynthese |
| Advanced | 0,122 US-Dollar pro Minute | 0,163 US-Dollar pro Minute | 0,110 US-Dollar pro Minute | Höhere Ebenen von LLMs |
| Advanced BYO TTS | 0,122 US-Dollar pro Minute | Genau wie im Moment | 0,110 US-Dollar pro Minute | Fortgeschrittener LLM mit integrierter TTS-Funktion |
Abrechnungsregeln und Kostenfallen
- Die Spracherkennung wird nach der tatsächlichen Zeit in Sekunden abgerechnet, ohne auf eine feste Anzahl von Minuten aufzurunden.
- Die Gebühren für mehrkanalige Audioaufnahmen werden nach der Gesamtverarbeitungszeit pro Kanal berechnet; 10 Minuten im Zweikanal-Modus werden als 20 Minuten betrachtet.
- Redaktion, Schlüsselwörter, Entitäten sowie ein Teil der Diarisation erfordern zusätzliche Gebühren.
- Audio Intelligence wird nach den eingegebenen und ausgegebenen Tokens abgerechnet und ist nicht im Preis pro STT enthalten.
- Ein Überschreiten der Kreditgrenze wird zum ursprünglichen Growth-Zinssatz plus 10 % berechnet und wöchentlich abgerechnet.
- Um das Übermaß an Nutzung zu aktivieren, muss eine gültige Kreditkarte vorhanden sein; andernfalls wird die Anfrage abgebrochen, sobald der Limit erreicht ist.
- Die Konkurrenzbeschränkung gilt pro Projekt; mehrere API-Schlüssel, die denselben Pool teilen, erhöhen die Kapazität nicht.
- Das Erstellen zusätzlicher Projekte zur Umgehung von Geschwindigkeitsbeschränkungen verstößt gegen die Nutzungsbedingungen.
- Nach Ablauf der Werbeaktionen und der zeitlich begrenzten kostenlosen Angebote kann sich die Stückkosten automatisch ändern.
Geschwindigkeitsbeschränkung
| Dienstleistungen | Standardbeschränkung für Pay-As-You-Go | Offene Beschränkungen für das Wachstum | Erklärung |
|---|---|---|---|
| Voice Agent | Maximal 45 gleichzeitige Verbindungen | Maximal 60 parallele Verbindungen | Nach Projekt berechnen |
| Flux STT Streaming | Maximal 150 parallele Anfragen | Die Planungsseite zeigt maximal 225 an. | Regionale Dokumente müssen erneut überprüft werden. |
| Nova-3 Pre-Recorded | Maximal 50 parallele Anfragen | Der offiziell angekündigte Plan beträgt 50. | Massenaufgaben |
| Nova-3 Streaming | Maximal 150 parallele Anfragen | Maximal 225 | Echtzeit-Transkription |
| Speaker Diarization Streaming | Höchstens 50 in Nordamerika, höchstens 25 in Europa und Australien | Gemäß Vereinbarung | Unter der normalen Durchflussbeschränkung |
| Text-to-Speech REST | Maximal 15 parallele Anfragen pro Modell | Der Gesamtüberblick zeigt das größere Gesamtvolumen. | Modell- und Gebietsbeschränkungen haben Vorrang |
| Audio Intelligence | Maximal 10 parallele Anfragen | Höchstens 10 | Zusätzliche Analyse |
Einrichtungsmethode
| Methode | Ausführungsort | Verantwortung für Betrieb und Wartung | Daten und Anwendungsgebiete |
|---|---|---|---|
| Hosted | Deepgram-Mehrfachmieter-Cloud | Deepgram ist für die Infrastruktur und Aktualisierungen zuständig. | Schnellstmöglicher Beginn der Entwicklung |
| Regionale Cloud | Endpunkte in Nordamerika, Europa oder Australien | Deepgram ist für die Verantwortung zuständig. | Regionale Verarbeitung und Datenverbleib |
| Dediziert oder VPC | Spezielles Cloud-Umfeld für Kunden | Nach Unternehmensvereinbarung | Isolierung und angepasste Kapazität |
| Self-Hosted | Kunden-VPC oder Rechenzentrum | Der Kunde ist für die Infrastruktur, die Backups und die Aktualisierungen verantwortlich. | Strenge Privatsphäre und niedrige Verzögerung |
| Amazon SageMaker | Kunde AWS VPC | AWS-hostete Endpunkte und Kunde-Konfigurationen | Modell über Marketplace bereitstellen |
Anforderungen an die selbst gehostete Version
Die lokale Bereitstellung unterstützt Docker, Podman, Kubernetes, Bare Metal sowie einige Cloud-Plattformen. Unterstützt werden nur Linux x86-64 oder amd64 sowie NVIDIA-GPUs. Nova und Aura bieten eine breitere Unterstützung, während das Flux-Modell höhere Anforderungen an die GPU-Generation und den Arbeitsspeicher stellt.
- Ein STT-Engine benötigt in der Regel mindestens eine NVIDIA-GPU mit 16 GB Grafikspeicher, einen 4-Kern-CPU und 32 GB RAM.
- Der TTS-Engine der Aura-Klasse benötigt genau 2 dedizierte GPUs, einen CPU mit 8 Kernen sowie 64 GB RAM.
- Flux TTS verwendet einen einzigen GPU, doch beim Laden kann er etwa 60 GB Systemram speichern.
- Selbst self-hostete Container benötigen weiterhin eine Lizenz sowie Berichte über die Nutzung – abgesehen von der SageMaker-Isolierungs-Lösung sind sie nicht automatisch vollständig offline.
- Der Kunde ist für die Überwachung, Kapazität, Backups, Aktualisierungen, Proxye und TLS-Terminierung verantwortlich.
- Die Selbstverwaltung von Docker, Podman oder Kubernetes erfordert in der Regel eine Enterprise-Lizenz.
Privatsphäre, Sicherheit und Verbesserung der Modelle
Deepgram überlässt die Regelungen bezüglich der Aufbewahrung, Speicherung und Löschung der Kundendaten der Unternehmen den in den Geschäftsvereinbarungen festgelegten Bestimmungen. Laut den Anleitungen zur Selbstverwaltung werden bei einer typischen Selbstverwaltungsanfrage weder Audio-Dateien noch Transkripte sowie andere Erkennungsergebnisse an Deepgram gesendet; stattdessen werden nur Metadaten wie Dauer, Anzahl der Zeichen, Funktionen und Status des Erfolgs übermittelt.
Kunden mit dem Pay-As-You-Go-Modell sowie mit dem Growth-Modell können sich dem Model Improvement Program anschließen oder wieder verlassen. Ein Austritt ab März 2026 beeinflusst die auf der Website angegebenen Tarife nicht. Bevor echte personenbezogene Daten verarbeitet werden, müssen die Optionen in der Konsole, der Standort, die Aufbewahrungsfrist sowie die Datenverarbeitungsvereinbarungen noch bestätigt werden.
- Deepgram macht die SOC 2 Type I- und Type II-Zertifizierungsdaten öffentlich.
- Enterprise-Kunden im Gesundheitswesen können einen BAA unterzeichnen, um elektronisch gesicherte Gesundheitsinformationen zu verarbeiten.
- Die europäischen Endpunkte dienen dazu, die Anforderungen an die Verarbeitung und Speicherung von Daten innerhalb der EU zu erfüllen.
- API-Schlüssel sollten nur auf der Serverseite gespeichert werden und nach Projekt, Umgebung sowie mit minimalem Berechtigungsgrad strukturiert sein.
- Redaktion kann nur das Exponierungsrisiko teilweise verringern, sie ersetzt nicht die Minimierung der Quelldaten.
- Vermeiden Sie es, im Protokoll das Originalaudio, vollständige Transkripte sowie langfristig gültige Schlüssel zu speichern.
- High-Risk-Voice-Agenten müssen Benachrichtigungen, Zustimmung zur Aufzeichnung, manuelle Übernahme sowie Audits bereitstellen.
SDK, GitHub und Open-Source-Status
Deepgram unterhält in der offiziellen GitHub-Organisation SDKs für JavaScript, Python, .NET, Go und Java und stellt Pakete für den Voice Agent-Browser bereit. In der aktuellen Dokumentation zum JavaScript SDK wird v5 als aktuelle Hauptversion angegeben; Projekte, die migriert werden sollen, sollten sich daher an die entsprechenden Anleitung zur Aufwertung wenden.
Mehrere offizielle SDKs werden unter der MIT-Lizenz bereitgestellt, wodurch Entwickler diesen Client-Code einsehen, ändern und verbreiten können. Die Deepgram-Cloudplattform, das Geschäftsmodell, die Modellgewichte sowie die selbst gehosteten Container sind dadurch jedoch keine Open-Source-Produkte.
| Projekt | Wartungspersonal | Status | Lizenz oder Anleitung |
|---|---|---|---|
| JavaScript- und TypeScript-SDK | Offizielle Seite von Deepgram | Öffentlich | MIT, aktuelle Hauptversion v5 |
| Python SDK | Offizielle Seite von Deepgram | Öffentlich | Gemäß der Lagerlizenz. |
| .NET SDK | Offizielle Seite von Deepgram | Öffentlich | MIT |
| Go SDK | Offizielle Seite von Deepgram | Öffentlich | MIT |
| Java SDK | Offizielle Seite von Deepgram | Öffentlich | MIT |
| Rust SDK | Gemeinschaft | Öffentlich | Nicht derselbe Grad an offizieller Unterstützung |
| Voice Agent SDK | Offizielle Seite von Deepgram | Öffentlich | MIT |
| Modellgewichte und Cloud-Plattformen | Deepgram | Nicht open source | Kommerzielle Produkte |
Unterstützte Sprachen und Plattformen
| Fähigkeiten | Sprache oder Plattform | Offener Status | Hinweise |
|---|---|---|---|
| Nova-Spracherkennung | Mehr als 45 Sprachen | Unterstützung | Die konkreten Funktionen variieren je nach Modell und Sprache. |
| Nova-3 Multilingual | Produktbeschreibungen in mehr als 50 Sprachen | Unterstützung | Automatische Spracherkennung |
| Flux STT Multilingual | 10 Sprachen | Unterstützung | Für Echtzeit-Dialoge |
| Flux TTS | Aktueller englischer Ton | Unterstützung | Weitere Sprachen sind noch in Planung. |
| Cloud-API | Serverseite und WebSocket | Unterstützung | Die regionalen Endpunkte sind unterschiedlich. |
| Self-Hosted | Linux x86-64 und NVIDIA-GPU | Unternehmensunterstützung | Die Hardware-Anforderungen variieren je nach Modell. |
| Mobile SDK | Keine eigenständige Verbraucher-App | Über die Backend- oder Web-Integration | Der Schlüssel darf nicht in den Client gelangen. |
Vorteile des Produkts
- Von STT, TTS bis hin zu Voice Agent: Ein kohärentes Sprachstack-Portfolio.
- Flux integriert das Ende der Runde sowie Feedback zu Unterbrechungen in das Dialogmodell, um externe Zusammenfügungen zu reduzieren.
- Nova-3 umfasst die Echtzeit- und Batch-Transkription sowie sprachbasierte und terminologische Erweiterungen.
- Die Abrechnung nach Sekunden vermeidet Verschwendung durch Aufgerundung auf volle Minuten.
- Es wird ein kostenloses Kreditlimit von 200 US-Dollar bereitgestellt, das zur Durchführung einer Bewertung echter Daten geeignet ist.
- Die Auswahl an Deployment-Optionen für Hosting, Regionen, VPC, lokal und SageMaker ist recht umfassend.
- Die offizielle SDK umfasst verschiedene gängige Server-Sprachen und stellt den Quellcode zur Verfügung.
- Die Unternehmenssicherheit, die medizinischen Vereinbarungen sowie die Optionen zur Datenspeicherung in der EU sind klar definiert.
Einsatzbeschränkungen und Hinweise
- Die Genauigkeit des Modells wird durch Sprache, Akzent, Störgeräusche, das Gerät, Fernbereich und überschneidende Sprachausgaben beeinflusst.
- Für Sonderpreise und zeitlich begrenzte kostenlose Angebote gilt ein klarer Endtermin; die langfristigen Kosten müssen zu den Standardpreisen geschätzt werden.
- Bei mehrkanaliger Aufnahme werden die Kosten aufgrund der Summe der Dauer jedes Kanals leicht unterschätzt.
- Einige Transkriptionsverbesserungsfunktionen sowie Audio Intelligence erfordern eine zusätzliche Gebühr.
- Die Standard-Parallelisierung ist durch das Projekt begrenzt und kann nicht durch die Erstellung weiterer Projekte umgangen werden.
- Ein Voice Agent muss bei der Ausführung externer Aktionen Berechtigungen, Parameter sowie die Bestätigung des Benutzers überprüfen.
- Emotions- und Absichtsmodelle können Fehler aufweisen und dürfen daher nicht als einzige Grundlage für Entscheidungen herangezogen werden.
- Selbstverwaltung erfordert eine GPU, Linux, Container-Management, lizenzierte Verbindungen sowie einen Unternehmensvertrag.
- Die Offenlegung des offiziellen SDKs bedeutet nicht, dass die Sprachmodelle oder die Plattform kostenlos in privater Umgebung eingesetzt werden können.
- Wichtige medizinische, rechtliche, finanzielle und identitätsbezogene Informationen müssen weiterhin manuell überprüft werden.
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name des Tools | Deepgram |
| Entwicklungsunternehmen | Deepgram, Inc. |
| Arten von Werkzeugen | Spracherkennung, Sprachsynthese und Voice-Agent-Plattformen |
| Hauptmodelle | Nova-3, Flux STT, Flux TTS, Aura-2 und Aura-1 |
| Hauptanschlüsse | REST API und WebSocket API |
| Kostenlose Nutzungsmenge | Neues Konto mit einer Kreditlinie von 200 US-Dollar |
| Preismuster | Nach Verbrauch, jährliche Vorauszahlung für Growth und maßgeschneiderte Lösungen für Enterprise |
| Wachstumsschwelle | Ab 4.000 US-Dollar pro Jahr |
| Hauptverteilung | Hosted, regionale Cloud, VPC, Self-Hosted und SageMaker |
| Chinesische Unterstützung | Nova-Serie wird unterstützt; die genauen Funktionen sind in der Tabelle der Modelliersprachen zu finden. |
| Ist eine Registrierung erforderlich? | Ja |
| Wird eine API bereitgestellt? | Ja |
| Offizielles SDK | JavaScript, Python, .NET, Go, Java usw. |
| Offizieller GitHub | Ja |
| Ist das SDK open source? | Ja, mehrere offizielle SDKs verwenden MIT. |
| Ist das Produkt open source? | Nein |
Empfehlungswert
Die Empfehlungswertung liegt bei 4,7 von 5 Punkten. Deepgram umfasst den gesamten Produktionsprozess – von der Echtzeit-Transkription über dialogbasierte TTS-Funktionen bis hin zu vollwertigen Voice Agents. Es stehen zahlreiche Modelle, Dokumentationen, SDKs sowie Optionen für regionale und lokale Implementierungen zur Verfügung.
Die Herausforderung besteht darin, dass es viele Produktlinien und Abrechnungskriterien gibt. Das Ende von Werbekampagnen, die Anzahl der Kanäle, zusätzliche Funktionen sowie die gleichzeitige Nutzung können alle den Gesamtkosten zugutekommen. Die sicherste Methode ist es, mit einem Kreditrahmen von 200 US-Dollar eine Realitätsprüfung durchzuführen und anschließend das Produktionsbudget anhand der Standardpreise zu schätzen.
Häufige Fragen
Ist Deepgram kostenlos?
Neue Konten erhalten einen kostenlosen Kreditrahmen von 200 US-Dollar – ohne Kreditkarte. Laut der Website gibt es keinen festgelegten Ablauftermin. Nach Ablauf des Kreditrahmens wird in Abhängigkeit vom tatsächlichen Verbrauch abgerechnet.
Wie viel kostet die Spracherkennung von Deepgram?
Der derzeitige Echtzeit-Preis für Nova-3 in einer Sprache beträgt 0,0048 US-Dollar pro Minute, für voraufgenommenes Audio 0,0043 US-Dollar pro Minute. Für mehrsprachige Versionen, Flux sowie zusätzliche Funktionen gelten andere Preise.
Ist Flux TTS dauerhaft kostenlos?
Nein. Flux TTS ist nur bis zum 12. September 2026 zeitlich begrenzt kostenlos. Ab dem 13. September beträgt der reguläre Preis 0,0450 US-Dollar pro 1000 Zeichen.
Wie wird die Gebühr für die Voice Agent API berechnet?
Es wird nach den Minuten des Gesprächs sowie der gewählten Kombination aus LLM und TTS abgerechnet. Der aktuelle Standardpreis beträgt 0,056 US-Dollar pro Minute; nach Ablauf der Aktion liegt der Preis bei 0,075 US-Dollar pro Minute.
Wird Chinesisch unterstützt?
Die Nova-Serie unterstützt Chinesisch und weitere Sprachen, doch die genauen Erkennungsfunktionen, Modelloptionen sowie die Verfügbarkeit in bestimmten Regionen richten sich nach der neuesten Liste der unterstützten Sprachen. Bei chinesischen Texten sollten weiterhin Akzente, englische Wörter sowie Fachbegriffe getestet werden.
Kann es lokal installiert werden?
Ja, Enterprise-Kunden können die Lösung in VPCs, auf Bare-Metal-Systemen oder in Container-Plattformen selbst hosten – oder sie kann auch über Amazon SageMaker bereitgestellt werden. Für die Hardware sind in der Regel Linux sowie NVIDIA-GPUs erforderlich.
Speichert Deepgram Audiodateien?
Die Speicherung und Löschung von Kundendaten in der Cloud erfolgt gemäß den Geschäftsvereinbarungen. Typische Self-Hosting-Anfragen senden weder Audio- noch Transkriptdaten an Deepgram, sondern liefern lediglich Metadaten zur Nutzung.
Kann man aus dem Modellverbesserungsprogramm austreten?
Ja, Pay-As-You-Go- und Growth-Kunden können sich anschließen oder wieder ausschließen. Ein Austritt ab März 2026 beeinflusst die auf der Website angegebenen Preise nicht.
Wie wird bei mehrkanaliger Wiedergabe abgerechnet?
Berechnet nach der Gesamtverarbeitungsdauer aller Kanäle. 10 Minuten Stereo-Audio werden als 20 Minuten Verarbeitungszeit abgerechnet.
Welche SDKs werden angeboten?
Offiziell werden SDKs für JavaScript, Python, .NET, Go und Java gewartet, außerdem werden Browser-Tools für Voice Agent bereitgestellt. Das Rust SDK ist ein Projekt der Community.
Ist Deepgram open source?
Produkte und Modelle sind nicht open source. Mehrere offizielle SDKs nutzen die MIT-Lizenz, was lediglich bedeutet, dass der Client-Zugriffscode öffentlich ist.
Zusammenfassung
Deepgram eignet sich für Entwicklerteams, die eine produktionsreife Echtzeit-Spracherkennung, dialogbasierte Sprachsynthese sowie Voice Agents benötigen. Zudem kann es durch regionale Endpunkte sowie self-hosted Services die Anforderungen bezüglich Unternehmensdaten und -deployment erfüllen. Nova-3 ist geeignet für allgemeine Transkriptionen, während Flux besser für Echtzeit-Dialoge geeignet ist, bei denen Umschaltungen und Unterbrechungen berücksichtigt werden müssen.
Vor dem Go-Live sollten Genauigkeit, Verzögerung, Konkurrenzfähigkeit, Kanäle, zusätzliche Funktionen sowie die Standardkosten nach Ablauf der Werbeaktion überprüft werden. Die Offenlegung des SDK senkt die Hürden für den Zugang, doch Modelle, Cloud-Dienste und selbst gehostete Container bleiben kommerzielle Produkte.
Tools, die dem Deepgram ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164