




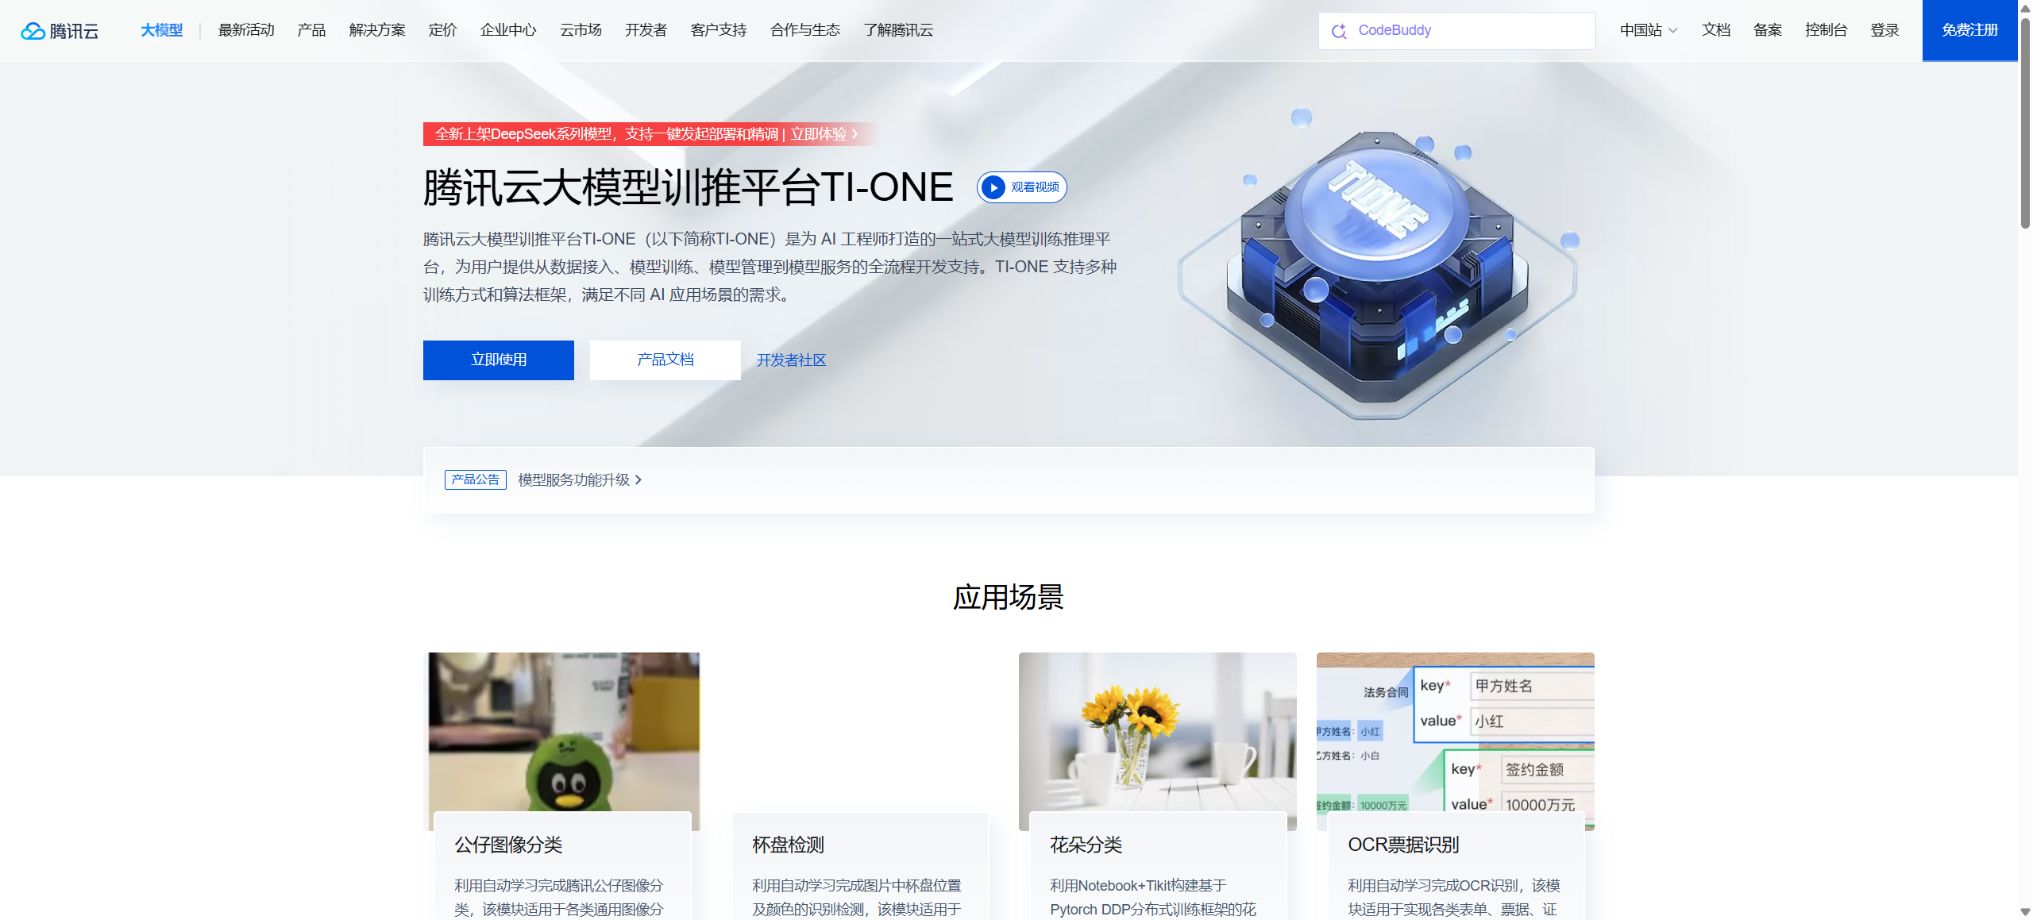
Tencent Cloud TI-Plattform
KI-Plattform zur Entwicklung, Schulung, Inferenz und Ressourcenverwaltung von Modellen
Tags:KI-TrainingsmodelleWas ist Tencent Cloud TI-ONE?
Die Tencent Cloud-Plattform für den Trainings- und Einsatz von großen Modellen, TI-ONE, ist eine umfassende Plattform für maschinelles Lernen und die Entwicklung großer Modelle. Sie umfasst Funktionen zur Datenvorbereitung, Entwicklung in der Cloud, verteilten Training, Feinabstimmung, Modellverwaltung, Bewertung, Bereitstellung von Inferenzfunktionen sowie Betrieb von Diensten. Sie richtet sich an Algorithmus-Ingenieure, Plattformteams sowie Unternehmens-AI-Zentren – es handelt sich dabei nicht um gewöhnliche Chatbots.
TI-ONE nutzt die GPU-Services von Tencent Cloud, inländische Rechenleistung sowie CVM, COS, CFS, GooseFS, Images sowie Monitoring- und Logging-Dienste, um die Entwicklung von Modellen mit ihrer Produktivumsetzung in einem einheitlichen Arbeitsumfeld zu vereinen.
Sechs Kernmodule
Die aktuelle Website unterteilt die Plattform in sechs Module: Datenzentren, Schulungswerkstätten, Workflows, Modellverwaltung, Modellservices sowie die Großmodell-Plattform. Zudem werden durch das Unternehmensmanagement und die Plattformverwaltung Ressourcen, Quoten und Berechtigungen gesteuert.
Unternehmen können Arbeitsräume nach Teams erstellen, um Daten, Modelle und Ressourcen zu trennen, während sie gleichzeitig Rechenressourcenpools und gemeinsame Images teilen können.
Datenzentrum
Datencenter dienen dazu, Datensätze zu erstellen, Objektspeicher mit Dateisystemen zu verknüpfen, Versionen zu verwalten und Annotationen durchzuführen. Trainingsaufgaben sollten einer klaren Datenversion zugeordnet werden, um zu verhindern, dass Daten überschrieben werden und somit nicht mehr rekonstruiert werden können.
Vor dem Hochladen müssen Desensibilisierung, Berechtigungsprüfung und Qualitätskontrolle durchgeführt werden. Sensible persönliche Daten, Kundendaten sowie urheberrechtlich geschützter Inhalt benötigen eine rechtmäßige Grundlage.
Cloud-Entwicklungssystem
Die Cloud-Entwicklungsumgebung bietet eine interaktive Entwicklungsplattform mit CPU oder GPU und eignet sich für Notebooks, Code-Debugging, Datenanalyse sowie kleine Experimente. Die Benutzer können das Image, die Ressourceneinstellungen sowie die Speicherkapazität auswählen.
Der kontinuierliche Betrieb des Entwicklungsrechners verursacht ständige Kosten. Bevor man den Rechner verlässt, sollte der Code gespeichert werden, die Instanz beendet werden und der Speicher sowie die geladenen Daten überprüft werden.
Trainingsaufgaben
Die Schulungswerkstatt unterstützt die Durchführung von Aufgabenbasierten Schulungen sowie verteilter Schulungen. Es sind Plattform-Images oder benutzerdefinierte Images nutzbar, außerdem kann man Knoten, Umgebungsvariablen, Startbefehle und Speicherpfade konfigurieren.
Für große Aufgaben sollten Breakpoints, Checkpoints sowie Mechanismen zur Wiederherstellung bei Fehlern eingestellt werden. Zudem sollten Code, Images, Daten, Zufallszahlen sowie Überparameter aufgezeichnet werden.
Einfache Feinabstimmung großer Modelle mit einer Klickung
Die Plattform verfügt über integrierte Vorlagen zur Anpassung großer, open-source-basierter Modelle, wodurch die Konfiguration von Umgebungen und verteilten Frameworks reduziert wird. Mit eigenen Daten kann sie für Szenarien wie Branchen-Fragen, Klassifizierung, Generierung und Befehlsbefolgung angepasst werden.
Bevor eine feine Abstimmung vorgenommen wird, sollte zunächst geprüft werden, ob die Prompte, die Suchverfahren zur Verbesserung der Ergebnisse oder die Aufrufe von Tools den Anforderungen entsprechen. Ein blindes, vollständiges Training erhöht die Kosten und das Risiko eines Überanpassungsphänomens.
Stärkung des Lernens durch Training
TI-ONE unterstützt nativ das Ray-Distributed-Framework und verfügt über veRL – dadurch können Reinforcement-Learning-Aufgaben mit nur einem Klick gestartet werden, um Präferenzen zu optimieren, die Inferenzfähigkeit zu verbessern und das Verhalten zu harmonisieren.
Für das verstärkte Lernen sind ein zuverlässiges Belohnungssystem, eine Baseline-Bewertung sowie sichere Beispiele erforderlich. Verzerrungen im Belohnungsmodell können dazu führen, dass das Modell spekuliert.
Platz der großen Modelle
Der Großmodell-Platz enthält Modelle wie Tencent Hunyuan, DeepSeek, Qwen, GLM und Kimi. Die Nutzer können eine Version auswählen und diese mit einem Klick als Inferenzdienst veröffentlichen; die Plattform empfiehlt dabei geeignete Ressourceneinstellungen.
„Einfache Bereitstellung“ bedeutet nicht, dass es keine Bewertung von Lizenzen, Kontext, Arbeitsspeicher, Konkurrenzfähigkeit und Sicherheit erforderlich ist. Modelle und Lizenzen müssen weiterhin separat geprüft werden.
Modellverwaltung
Das Modellarchiv speichert zentral die Ergebnisse des Trainings, die Versionen, die Quellen sowie die Informationen zur Bereitstellung – damit ein Rücksetzen und eine Überprüfung erleichtert werden. Das Team sollte für jede Version Datensätze, Code-Änderungen, Bewertungsergebnisse sowie die Verantwortlichen dokumentieren.
Das Hochladen nur der Gewichte ohne Tokenizer, Konfiguration und Inferenzcode kann dazu führen, dass das Ergebnis später nicht reproduziert werden kann.
Online-Logikdienst
Der Modell-Service ermöglicht es, Modelle als Online-Schnittstellen zu bereitstellen, wobei Kopien, GPUs, Images, Umgebungsvariablen, Authentifizierung sowie Netzwerke konfiguriert werden können. Die Plattform unterstützt außerdem den Status der Dienste, Logs, Metriken sowie Aufzeichnungen von Anfragen.
Vor dem Go-Live müssen Belastungstests durchgeführt, Kapazitätsplanungen erstellt, Einstellungen für Zeitüberschreitungen und Trafficbegrenzungen vorgenommen sowie Downgrade-Pläne entworfen werden.
PD-getrennte Bereitstellung
Durch die PD-Trennung werden die Phasen Prefill und Decode auf unterschiedliche Knoten verteilt, wodurch Rechenleistung und Kopien separat konfiguriert werden können. Laut der offiziellen Dokumentation kann dies in geeigneten Szenarien die Verzögerungen bei der Übertragung der ersten Zeichen sowie der Pakete erheblich verringern.
Diese Architektur eignet sich besser für große Modelle mit hoher Konkurrenzlast und langen Kontexten; bei kleinerem Umfang kann sie die Komplexität im Netzwerk und bei der Scheduling-Logik erhöhen.
TACO-Logikbeschleunigung
TACO ist ein von Tencent Cloud selbst entwickelter Inferenzmotor, der LLMs, VLMs und DiTs abdeckt. Basierend auf den Angaben auf der offiziellen Website kann er im Vergleich zu vLLM die Durchsatzrate erhöhen und die Verzögerung bei der ersten Ausgabe verringern; die genauen Effekte hängen jedoch vom Modell, der Hardware, der Quantisierung sowie vom Datenverkehr ab.
Die Referenzwerte können nicht direkt mit dem Geschäft der Nutzer gleichgesetzt werden. Zur Belastungstests sollten die tatsächliche Eingabelänge, die Ausgabellänge sowie die Konkurrenzfähigkeit herangezogen werden.
Schlussfolgerungsparameter
TI-ONE stellt für Modelle wie Hunyuan und DeepSeek Umgebungsparameter bereit, darunter die Kontextlänge, die Anzahl der Tokens pro Batch, die Auslastung des Grafikspeichers, Quantisierung, Präfix-Caching, Denkausgaben sowie spekulative Dekodierung.
Eine Erhöhung des Kontexts und der Parallelisierung erhöht den Speicherbedarf. Die Aktivierung von Spekulation und Quantisierung kann die Ausgabekonstanz verändern; es sind daher Wiederholungstests erforderlich.
Automatische Skalierung
Der Modellservice unterstützt manuelle, zeitbasierte sowie HPA-gesteuerte Skalierung – es ist möglich, die Anzahl der Kopien je nach Geschäftsanforderungen anzupassen. Die Skalierung bei geringer Belastung spart Kosten, während die Erweiterung bei hoher Belastung eine ausreichende Leistung gewährleistet.
Die Skalierungsrate hängt von den Abbildungen, der Gewichtung der Ladevorgänge sowie vom verfügbaren Ressourcenbestand ab. Kerndienste sollten mindestens eine Kopie beibehalten und im Voraus vorbereitet werden.
Graustufen-Veröffentlichung und Rollback
Die Plattform unterstützt mehrere Versionen im schrittweisen Einsatz, einen reibungslosen Übergang sowie ein Zurückfallen auf eine frühere Version – ideal zur Überprüfung neuer Modelle bei geringem Datenverkehr. Vollständige Protokolle der Anfragen erleichtern die Audits und die Identifizierung von Problemen.
Protokolle können Benutzertipps und sensible Informationen enthalten, weshalb Maskierung, Zugriffskontrolle und eine Aufbewahrungsfrist erforderlich sind.
Bewertung großer Modelle
TI-ONE verfügt über integrierte Open-Source-Bewertungssätze, benutzerdefinierte Bewertungssätze, eine Bewertungsmethode für Schiedsmodell sowie einen Radarchart zur Vergleich von mehreren Modellen. Die Bewertungen können zur Auswahl der geeigneten Lösung, zur Feinabstimmung vor dem Einsatz sowie zur Festlegung der Einsatzvoraussetzungen genutzt werden.
Offizielle Listen können die tatsächlichen Aufgaben eines Unternehmens nicht ersetzen. Auch die Bewertungsmodelle sind voreingenommen und sollten stichprobenartig von Menschen überprüft werden.
Workflow-Orchestrierung
Der Drag-and-Drop-Workflow verbindet Datenverarbeitung, Training, Bewertung und Bereitstellung zu einem wiederholbaren Prozessstrom und unterstützt zeitbasierte oder ereignisgesteuerte Auslösungen. Er trägt dazu bei, manuelle Eingriffe sowie Unterschiede in der Umgebung zu verringern.
Workflow-Node benötigen feste Eingaben, Ausgaben und Versionen. In der Produktionsumgebung sollten Wiederholungsversuche, Idempotenz sowie die Beseitigung von Fehlern getestet werden.
Heterogene Rechenleistung und inländische GPU’s
Die Plattform kann NVIDIA sowie inländische Recheneinheiten wie Hygon, KunlunX, TianShu und Zixiao zentral verwalten und bietet Treiber, Frameworks, Scheduling-Verfahren sowie Anpassungen auf Plattformesebene.
Die Kompatibilität des Modells sowie seine Leistung hängen weiterhin von den Operatoren, der Genauigkeit und der Toolchain ab. Vor der Migration sollten Korrektheit und Durchsatz überprüft werden.
GPU-Virtualisierung
TI-ONE unterstützt die Virtualisierung und Aufteilung von GPUs; auf der offiziellen Website wird angegeben, dass ein Mindestdurchsatz von 0,01 GPU möglich ist. Zudem werden Ressourcengruppen, Quoten sowie voreingestellte Spezifikationen genutzt, um die Auslastung zu erhöhen.
Feingranulares Teilen eignet sich für Entwicklungs- und Inferenzarbeiten mit geringer Last, ist aber nicht unbedingt geeignet für Training, das an Bandbreite und Grafikspeicher gebunden ist.
Tidensteuerung und -planung
Durch die Steuerung der Gezeiten wird sichergestellt, dass hochpriorisierte Aufgaben Vorrang vor weniger wichtigen Trainingsaufgaben haben, und dass freie Ressourcen an andere Aufgaben abgegeben werden können, um tagsüber Dienstleistungen anzubieten und nachts zu trainieren.
Die übernommene Ausbildung muss Checkpoints sowie die Wiederherstellung unterstützen, da sonst Energieeinsparungen zu einem Neustart der Aufgabe führen können.
Tools für körperbasierte Intelligenz
Die offizielle Website zeigt derzeit Fähigkeiten in der Simulation von Weltmodellen, im Training mehrmodaler Großmodelle sowie in der Entwicklung von embodied Intelligence – geeignet für die Wahrnehmung, Steuerung und Verarbeitung von Simulationsdaten bei Robotern.
Solche Projekte beinhalten außerdem Sensoren, Simulationsdifferenzen und physische Sicherheit – die Trainingsfähigkeiten der Plattform können die Überprüfung vor Ort nicht ersetzen.
Governance der Unternehmensrechte
Das zweistufige System aus Unternehmensverwaltung und Arbeitsumgebung ermöglicht die Konfiguration von Mitgliedern, Rollen, Ressourcengruppen, Quoten sowie Modulrechten und eignet sich für den gemeinsamen Einsatz von GPU-Clustern in mehreren Teams.
Administratoren sollten das Prinzip der geringsten Berechtigungen befolgen, Entwicklungs-, Bereitstellungs- und Prüfrollen trennen sowie die Schlüssel regelmäßig austauschen.
Preis- und Versionsvergleich
| Paket oder Version | Preise, Limits und Kernvorteile |
|---|---|
| Wie wird TI-ONE abgerechnet? | Die Kosten für die öffentliche Cloud setzen sich aus der Rechenleistung der Knoten sowie den Kosten für das TI-ONE-Softwarepaket zusammen. Die Maschinen können direkt bei TI-ONE erworben werden – oder mit bereits vorhandenen CVMs verbunden werden. Bei der direkten Anschaffung werden sowohl die Rechenleistungsgebühren als auch die Softwarekosten berechnet; bei der Verbindung mit bestehenden CVMs werden nur die Softwarekosten je nach Nutzungsdauer in TI-ONE berechnet, wobei die CVMs selbst separat abgerechnet werden. Zudem können COS, CFS, GooseFS, TCR, Überwachungsfunktionen, Protokolldaten, Lastverteilung sowie das Netzwerk jeweils separat abgerechnet werden. |
| Beispiele für Rechenleistungskosten | Im Juni 2026 wurden offiziell zahlreiche Spezifikationen veröffentlicht. Beispielsweise beträgt die Kosten für eine T4-Karte etwa 3,72 Yuan pro Stunde; für eine einzelne T4-Karte liegen die Kosten bei etwa 9,55 Yuan pro Stunde. Für eine 4090d-Karte sind es etwa 12,97 Yuan pro Stunde, und für eine 4090-Karte etwa 16,51 Yuan pro Stunde. Bei hochwertigen Systemen mit mehreren Karten können die Kosten auf Hunderte von Yuan pro Stunde steigen. Dies sind nur Beispiele für die Preisangaben. Region, Aktionen, Lagerbestände sowie Softwarekosten können die tatsächlichen Kosten beeinflussen – daher sollte man immer die Preise direkt über die Konsole erfragen. |
Wie wird TI-ONE abgerechnet?
Die Kosten für die öffentliche Cloud setzen sich aus der Rechenleistung der Knoten sowie den Kosten für das TI-ONE-Softwarepaket zusammen. Die Maschinen können direkt bei TI-ONE erworben werden, oder sie können auch an bestehende CVMs angebunden werden.
Ersterer berechnet Rechenleistung und Softwaregebühren, letzterer berechnet nur die Softwaregebühr nach der Dauer der Nutzung in TI-ONE; CVM wird separat abgerechnet.
Außerdem können COS, CFS, GooseFS, TCR, Überwachung, Protokolle, Lastverteilung und Netzwerk separat abgerechnet werden.
Nach Verbrauch und Monatsabonnement
Maschinen können bei TI-ONE entweder nach Verbrauch oder im Monatsabonnement erworben werden. Im Verbrauchsmodell wird für Zeiträume unter einer Stunde pro Sekunde abgerechnet, pro Stunde erfolgt die Abrechnung.
Monatsgebühr ab mindestens einem Monat, geeignet für konstante Lasten.
Laut den offiziellen Dokumentationen wird bei einer Pay-as-you-go-Bestellung die Gebühr zunächst für 2 Stunden eingefroren, bis sie freigegeben wird. Vor der Erstellung sollte sichergestellt werden, dass ausreichend Guthaben vorhanden ist.
Beispiele für Rechenleistungskosten
Im Juni 2026 wurden offiziell zahlreiche Spezifikationen veröffentlicht. Beispielsweise liegen die Kosten für eine T4-Karte bei etwa 3,72 Yuan pro Stunde, für eine einzelne T4-Karte bei etwa 9,55 Yuan pro Stunde, für eine 4090d-Karte bei etwa 12,97 Yuan pro Stunde und für eine 4090-Karte bei etwa 16,51 Yuan pro Stunde.
High-End-Multikarten-Node können mehrere hundert Yuan pro Stunde kosten.
Dies sind Beispiele für die regulären Preise. Region, Veranstaltung, Lagerbestand und Softwarekosten können den tatsächlichen Betrag beeinflussen; es sollte stets der Preis aus der Konsole herangezogen werden.
API und SDK
Tencent Cloud bietet die TI-ONE-API an, mit der Ressourcen verwaltet, Modelle trainiert sowie Abrechnungsparameter gesteuert werden können. Sie kann über das Tencent Cloud SDK, die Kommandozeile und den API Explorer aufgerufen werden.
API-Schlüssel sollten in einem Schlüsselverwaltungstool oder in Umgebungsvariablen gespeichert werden und nicht in Notebooks oder öffentlich zugänglichem Code festgehalten werden.
GitHub und der Open-Source-Zustand
Die TI-ONE-Plattform selbst ist ein geschlossener Cloud-Dienst. Tencent Cloud hat die Sammlung an Beispielen „tione-examples“ veröffentlicht, die unter der Apache 2.0-Lizenz steht;
Die Tencent-Ti-Organisation verfügt auch über ein Tool zur Anfrage von Signaturen.
Die Offenlegung der Beispiele und des Signatur-SDKs als Open Source bedeutet nicht, dass der Server der Plattform, der TACO-Engine oder das Scheduling-System vollständig offen zugänglich sind.
Anleitung zur Verwendung von Tencent Cloud TI-ONE
Eine grundlegende Aufgabe erledigen
- Installieren und konfigurieren Sie Tencent Cloud TI-ONE, um für das Experiment separate Projekte sowie Laufnamen einzurichten;
- In dem Trainingsskript sollten Hyperparameter, Datenversionen, Codeversionen sowie die Zufallszahlenseed festgehalten werden;
- Die Initialisierungsaufgabe wird über sechs Kernmodule durchgeführt und es werden die richtigen Cloud- oder Private-Service-Instanzen verbunden;
- Verwenden Sie ein Rechenzentrum, um kontinuierlich Verluste, Kennzahlen, Protokolle sowie den Zustand der Hardware zu erfassen;
- Führen Sie ein kleines Trainingslauf durch, um zu überprüfen, ob Schrittanzahl, Einheiten, Kurven und Medienbeispiele korrekt sind;
- Speichern Sie nach Abschluss das Modell, die Einstellungen, die Ergebnisse sowie die Anleitung zur Wiederholung des Experiments.
Erstellung wiederverwendbarer professioneller Workflows
- Einheitliche Normen für die Benennung von Projekten, Experimenten, Indikatoren und Labels;
- Die sechs Kernmodule, die Rechenzentren sowie die Cloud-Entwicklungsumgebungen sollen in das Schulungsmuster aufgenommen werden.
- Versionen für Datensätze, Code, Umgebungen und Modelle verknüpfen;
- Verwenden Sie dasselbe Bewertungsset und dieselben Vergleichsexperimente, um zu vermeiden, sich nur auf glatte Kurven zu konzentrieren;
- Einschränkung des Upload-Bereichs für sensible Proben, Prompts und Modellausgaben;
- Stellen Sie Alarme für Ausnahmen, Speicherungspolitiken sowie manuelle Überprüfungen ein, bevor Sie sie auf das Team ausweiten;
Für welche Nutzer geeignet?
- Unternehmensalgorithmen-Teams für das Training, die Feinabstimmung und den Einsatz großer Modelle;
- Es ist notwendig, Abteilungen für die zentrale Verwaltung von GPUs sowie inländischen Rechenressourcen einzurichten;
- Unternehmen, die hochskalierbare Online-Inferenzdienste entwickeln;
- Es werden Teams für Modellversionen, Bewertungen, Graustufen und Audits benötigt;
- Einrichtungen, die sich mit autonomen Fahrzeugen, Bildung, Robotern und KI in der Industrie beschäftigen.
Vorteile des Produkts
- Ganzer Prozess: Daten, Training, Modelle und Dienste;
- Integrierte große Mainstream-Modelle und fein abgestimmte Vorlagen;
- PD-Trennung, TACO und automatische Skalierung;
- Unterstützung für verstärktes Lernen und Modellbewertung;
- Einheitliche Verwaltung von NVIDIA und inländischer Rechenleistung;
- Rechte, Quoten und Audits für Unternehmen sind recht umfassend.
Einschränkungen und Hinweise
- TI-ONE ist für professionelle Entwicklungsarbeiten konzipiert und erfordert ein Verständnis von Cloud-Ressourcen, Containern sowie verteilter Trainings- und Inferenzverarbeitung.
- Die Kosten betreffen nicht nur die GPU, sondern auch Software, Speicher, Protokolle und das Netzwerk;
- Der Einsatz großer Modelle beinhaltet Aspekte wie Lizenzen, Datensicherheit, Protokollierung von Anfragen, Inhaltssicherheit sowie Kostenmanagement – es reicht nicht aus, das Modell einfach per Knopfdruck in Betrieb zu nehmen.
Häufige Fragen
Ist TI-ONE kostenlos?
Es handelt sich nicht um ein kostenloses Produkt auf Dauer. Es können zwar Testversionen oder Aktionen vorhanden sein, doch der Betrieb von Entwicklungsrechnern, für Schulungen und Dienste wird nach der Rechenleistung, den Software-Ressourcen sowie den damit verbundenen Cloud-Ressourcen abgerechnet.
Kann DeepSeek eingesetzt werden?
Ja, der Large Model Plaza sowie die offiziellen Inferenzleitfäden decken mehrere Versionen von DeepSeek ab und bieten optimierte Images sowie Parameter.
Kann man bestehende CVMs wiederverwenden?
Ja. Beim Wiederverwenden einer CVM wird eine Gebühr für die TI-ONE-Software erhoben, während die Ressourcen der CVM weiterhin nach dem ursprünglichen Auftrag abgerechnet werden.
Wird eine inländische GPU unterstützt?
Es werden verschiedene inländische Rechenleistungssysteme wie Hyguang, KunlunXin, TianShu und ZiXiao unterstützt. Die genaue Kompatibilität mit bestimmten Modellen und Regionen muss über die Konsole überprüft werden.
Ist TI-ONE open source?
Die Plattform ist nicht open source; die offiziellen Beispiele sowie einige Signaturwerkzeuge sind open source, während die Kern-Cloud-Dienste und Beschleunigungsmechanismen nicht vollständig öffentlich zugänglich sind.
Werkzeuge, die der TI-Plattform von Tencent Cloud ähneln


 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164