




Bethge Lab
Bethge Lab – intelligente Tools für die KI-gestützte Suche
Tags:KI-SuchmaschineEine kurze Beschreibung
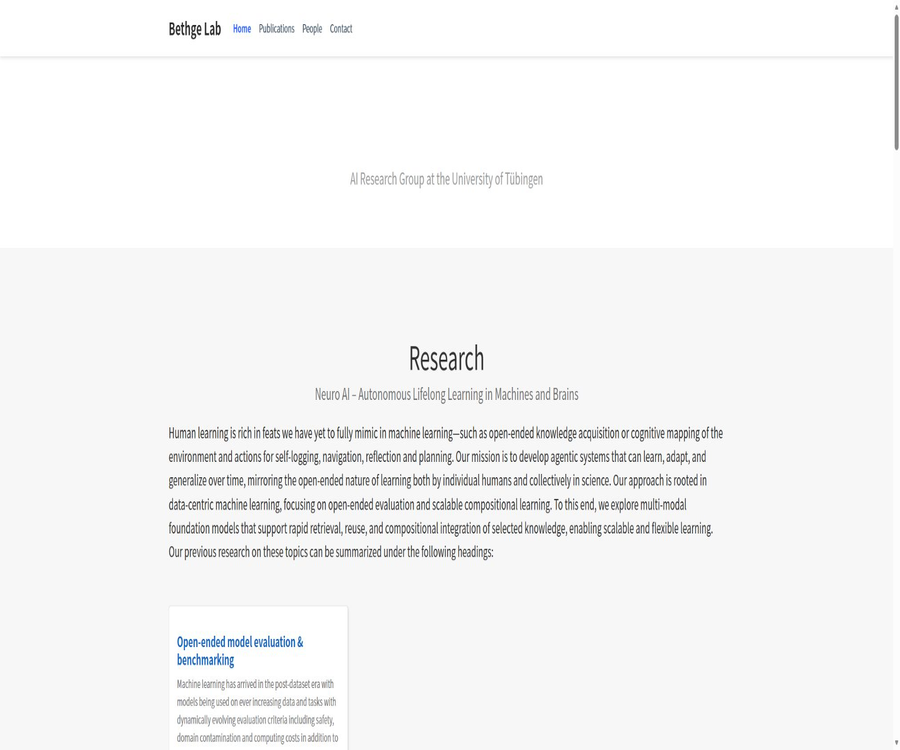
Das Bethge Lab ist ein Forschungsteam für KI und computergestützte Neurowissenschaften an der Universität Tübingen. Die offizielle Website zeigt die Forschungsschwerpunkte, die Teammitglieder, wissenschaftliche Artikel, Datensätze sowie Open-Source-Code – es werden jedoch keine Online-Chats oder Dienste zur Erstellung von Inhalten angeboten.
Einführung in das Labor
Das Bethge-Lab wird von Matthias Bethge geleitet und forscht in den Bereichen Maschinelles Lernen, computergestützte Neurowissenschaften, Visuelle Wissenschaften sowie autonomes lebenslanges Lernen. Ziel ist es, die Mechanismen des Schlussfolgerns und Lernens im biologischen Gehirn zu verstehen sowie maschinelle Systeme zu entwickeln, die sich kontinuierlich anpassen, Wissen kombinieren und generalisieren können.
Matthias Bethge ist Professor für computergestützte Neurowissenschaften und maschinelles Lernen an der Universität Tübingen sowie Leiter des Tübinger AI-Zentrums. Das Labor arbeitet mit örtlichen Universitäten, den Max-Planck-Instituten, ELLIS sowie anderen wissenschaftlichen Netzwerken zusammen.
Es ist kein gewöhnliches AI-Tool.
- Es gibt weder ein Eingabefeld für Anweisungen für die Öffentlichkeit noch eine allgemeine AI-Chat-Oberfläche.
- Es werden keine monatlichen Abonnements für Schreib-, Such- oder Bürosoftware angeboten.
- Die offizielle Website dient hauptsächlich dazu, sich über Projekte zu informieren, wissenschaftliche Artikel zu lesen, Mitglieder zu finden und Stellen anzumelden.
- Tatsächlich nutzbare Ressourcen befinden sich in der Regel in den Anhängen der Artikel, in Code-Repositories sowie auf den Seiten mit Datensätzen.
- Verschiedene Forschungsprojekte weisen unterschiedliche Abhängigkeiten, Lizenzen, Wartungszustände und Schwierigkeitsgrade bei der Reproduzierbarkeit auf.
Aktuelle Schwerpunkte der Forschung
Bewertung und Benchmarks für offene Modelle
Das Labor konzentriert sich auf die Bewertungsprobleme im Zeitalter der Datensätze nach dem Erscheinen von Modellen, einschließlich sich ständig ändernder Aufgaben, Sicherheit, Datenverschmutzung, Rechekosten und der Demokratisierung der Bewertung. Zu diesem Zweck versuchen entsprechende Forschungen, statische Ranglisten in nachhaltige, kombinierbare und pro-Beispiel-basierte offene Bewertungen zu erweitern.
Sprachmodell-Agenten
In dieser Forschungsrichtung werden sprachbasierte Modelle von Intelligenzagenten untersucht, die in der Lage sind, zu reasoning, zu kommunizieren und Aufgaben autonom auszuführen. Zu den offenen Problemen gehören der Beweis von Sätzen, die Automatisierung wissenschaftlicher Entdeckungen, die Suche nach wissenschaftlichen Referenzen sowie die Aggregation von Informationen über unsichere zukünftige Ereignisse.
Lebenslanges Kombinations- und zielorientiertes Lernen
Die Forscherinnen und Forscher sind der Ansicht, dass kontinuierliches Lernen nicht nur dazu dient, katastrophales Vergessen zu vermeiden, sondern auch dazu, vergangene Erfahrungen zu Modulen zu machen, die in der Zukunft wiederverwendet werden können. Die Forschung verbindet dabei Generalisierung, zielorientierte Repräsentationen, multimodales Vortrainieren sowie skalierbares lebenslanges Lernen miteinander.
Neuronale Repräsentationen und Erklärbarkeit von Mechanismen
Das Forscherteam nutzte maschinelles Lernen zur Analyse von Nervendaten, um herauszufinden, wie Gruppen von biologischen Neuronen Schlussfolgerungen ziehen und lernen. Die Arbeit umfasste digitale Zwillinge der Netzhaut und des visuellen Kortex, den Vergleich von neuronalen Repräsentationen sowie Modelle von Gehirnregionen, die nach Bedarf detailliert wurden.
Die Aufmerksamkeit des Menschen und der Maschine
In dieser Richtung werden Merkmale wie Aufmerksamkeit, Blicke und Augenbewegungen in Bildern, Videos und virtueller Realität untersucht. Zudem werden menschliche Mechanismen der Aufmerksamkeit mit denen der maschinellen Vision verglichen. Eines der Ziele ist es, Aufmerksamkeitsmodelle zu verwenden, die besser den menschlichen Verhaltensweisen entsprechen, um visuelle und verhaltensbezogene Studien durchzuführen.
KI-Wissenschafts-Unternehmertum
Das Labor konzentriert sich auch darauf, Forschungsergebnisse im Bereich des maschinellen Lernens in Lösungen mit langfristigem praktischem Wert umzuwandeln, und arbeitet dabei mit aus diesen Forschungen hervorgegangenen Unternehmen zusammen. Die auf der Website aufgeführten Unternehmertumskonzepte und Kooperationsmöglichkeiten bedeuten nicht, dass das Labor einheitliche kommerzielle Produkte an die Öffentlichkeit verkauft.
Vergleich der Forschungsbereiche
| Forschungsschwerpunkte | Hauptprobleme | Typische Ressourcen | Für Leser geeignet |
|---|---|---|---|
| Offene Bewertung | Wie man Modelle, die sich ständig verändern, kontinuierlich bewerten kann | Bewertungsrahmenwerke, Benchmarks und Datensätze | Forscher zu Bewertung und Governance von Modellen |
| Sprachmodell-Agenten | Wie man die Fähigkeiten im logischen Denken, bei der Zitierung von Quellen sowie bei der Zusammenarbeit an Aufgaben verbessern kann | Arbeiten, Referenzwerte und Experimentiercode | Forscher zu NLP und Agenten |
| Lebenslanges kombiniertes Lernen | Wie man Wissen wiederverwenden und das Vergessen verringern kann | Continuierliches Lernen und multimodale Projekte | Forscher im Bereich maschinelles Lernen |
| Neuronale Repräsentationen | Wie Nervengruppen berechnen und lernen | Neuronale Datenmodelle und Analysecode | Forscher im Bereich der künstlichen Neuronenforschung |
| Mensch-Maschine-Aufmerksamkeit | Wie lässt sich die menschliche Augenbewegung mit der Aufmerksamkeit von Maschinen vergleichen? | Signifikanzmodelle, Augenbewegungsdaten und Referenzwerte | Forscher im Bereich der Visuellen und Kognitiven Wissenschaften |
| Wissenschaftliches Unternehmertum | Wie werden Forschungsergebnisse in umsetzbare Lösungen umgewandelt? | Informationen zu Kooperationsprojekten und Tochtergesellschaften | Untersuchung von Unternehmern |
Ressourcen auf der offiziellen Website
- Überblick über die Forschung: Schnelle Einordnung der aktuellen Mission und Hauptaufgaben des Teams.
- Inhaltsverzeichnis der Artikel: Durchsuchen Sie Artikel, Preprinte und Vortragsmanuskripte nach Jahr und Veröffentlichungsart.
- Projektanhang: Einige Arbeiten liefern PDFs, Code, Datensätze, Projektseiten, Videos oder Präsentationsfolien.
- Mitgliederseite: Sehen Sie sich die Leiter, Postdoktoranden, Doktoranden, Masterstudenten, Verwaltungsmitarbeiter und Absolventen an.
- Antragsseite: Erfahren Sie mehr über Möglichkeiten für Postdoktoranden, Doktoranden, Praktika, Rotationen und Dissertationen.
- Nachrichten und Zusammenarbeit: Einen Überblick über Laboraktivitäten, wissenschaftliche Kooperationen und Projekte mit gesellschaftlichem Impact.
Themen repräsentativer Aufsätze
Der Verzeichnis der Artikel umfasst Themen wie visuelle Aufmerksamkeit, Modellierung von neuronalen Daten, kontinuierliches Lernen, kombinierte Generalisierung, multimodale Modelle sowie die Bewertung großer Sprachmodelle. Der Status der Artikel im Verzeichnis kann „offiziell veröffentlicht“, „Vortragsbeitrag auf einer Konferenz“ oder „Preprint“ sein; bei Zitierungen sollte die jeweilige Version überprüft werden.
- Bewertung von Modellen auf Probenstufe für offene Fähigkeiten.
- Fähigkeit, wissenschaftliche Behauptungen mit Literaturverweisen abzugleichen.
- Anhaltende Vortrainierung und Kombination von multimodalen Modellen.
- Konzept der Häufigkeit in visuellen Sprachmodellen und Leistung ohne Beispieldaten.
- Zielzentriertes Lernen und kombinierte Generalisierung.
- Anpassung und distribuierte Generalisierung bei kontinuierlichen Tests.
- Prognose der menschlichen visuellen Aufmerksamkeit, Signifikanz und Scannpfade.
- Funktionsmodellierung der Netzhaut und des visuellen Kortex.
Open-Source-Ressourcen von GitHub
Die GitHub-Organisation, die denselben Namen wie das Labor trägt und deren Hauptseite auf die offizielle Website verweist, verfügt derzeit über Dutzende öffentlicher Repositorien. In diesen werden hauptsächlich Implementierungen von Artikeln, Benchmarks, Werkzeuge zur Datenverarbeitung sowie Experimentiercodes gespeichert. Die Repositorien bilden kein einheitliches Softwarepaket; vor der Nutzung müssen die jeweiligen Anleitungen und Lizenzen geprüft werden.
Foolbox
Foolbox ist ein Python-Toolkit zur Erstellung von Adversarial Examples für neuronale Netze, das mit PyTorch, TensorFlow und JAX verwendet werden kann. Es eignet sich für die Untersuchung der Robustheit sowie zur Bewertung von Modellen und sollte nicht zur Durchführung unbefugter Angriffe auf echte Systeme genutzt werden.
imagecorruptions
ImageCorruptions bietet die Möglichkeit, mit Python gängige Verfälschungen an Bilder hinzuzufügen, was zur Überprüfung der Stabilität von Modellen gegenüber Rauschen, Unschärfe, Wetterbedingungen und digitalen Verzerrungen genutzt werden kann. Der Repository wird unter der Apache 2.0-Lizenz bereitgestellt, wobei die Eingabedaten und Modelle möglicherweise eine eigene Lizenz haben.
model-vs-human
model-vs-human wird verwendet, um Modelle mit menschlichem Verhalten an Daten außerhalb der Verteilung zu vergleichen. Dieses Projekt eignet sich dazu, zu untersuchen, ob die Maschinenvision auf anderen Hinweisen beruht als Menschen. Im aktuellen Repository werden die Standardlizenzen in den Metadaten nicht ausdrücklich angegeben.
CiteME und ONEBench
CiteME konzentriert sich darauf, ob Sprachmodelle die in wissenschaftlichen Texten zitierten Arbeiten wiederfinden können, während ONEBench sich auf Benchmarks auf Sample-Ebene für offene Fähigkeiten konzentriert. Beide können zur Bewertung von Forschungen verwendet werden, wobei Daten, Code und Bewertungsergebnisse gemäß den Anweisungen der jeweiligen Repositorien interpretiert werden müssen.
Jüngste Studien zu Lagerhäusern
Die Organisation hat außerdem Projekte wie die Bewertung lebenslanger Modelle, multimodales Vortrainieren, Verstärkungslernen, neuronale Repräsentationen sowie Sprachbenchmarks veröffentlicht. Die Aktualisierungszeiten des Repositoriums unterscheiden sich vom Veröffentlichungsrhythmus der wissenschaftlichen Arbeiten; daher kann eine kürzlich eingefügte Version nicht direkt mit einer stabilen Version gleichgesetzt werden.
Vergleich von Open-Source-Projekten
| Projekt | Verwendung | Hauptsprache | Lizenzstatus | Hinweise |
|---|---|---|---|---|
| Foolbox | Gegenbeispiele und Bewertung der Robustheit | Python | MIT | Nur für autorisierte Forschung und Tests. |
| imagecorruptions | Bildkorrosion und Robustheitstests | Python | Apache 2.0 | Überprüfung von Daten und Modellberechtigungen |
| model-vs-human | Vergleich von Modellen mit menschlichem Verhalten | Python | Die Lager-Metadaten sind nicht klar definiert. | Lesen Sie die Projektdatei vor der Verwendung. |
| CiteME | Bewertung der Suche nach wissenschaftlichen Zitaten | Python | Nicht-standardmäßige Angaben | Überprüfen Sie jeweils die Datensätze und die Codierungsregeln. |
| ONEBench | Offene Bewertung auf Probenebene der Fähigkeit | Python | MIT | Das Ergebnis hängt von der Stichprobe und der Bewertungskonfiguration ab. |
| frequency_determines_performance | Studie zur Frequenz des multimodalen Vortrainings | Notebook | MIT | Die Reproduktion erfordert möglicherweise große Datenmengen und Rechenleistung. |
Wie findet man die richtigen wissenschaftlichen Arbeiten?
- Zunächst wird anhand eines Überblicks der Forschung festgestellt, ob das Thema zur Bewertung, zu Agenten, zum lebenslangen Lernen, zu neuronalen Repräsentationen oder zur Aufmerksamkeit gehört.
- Gehen Sie zum Inhaltsverzeichnis der Artikel und beschränken Sie die Suche nach Jahr, Konferenz oder Art des Artikels.
- Lesen Sie den Titel und die Zusammenfassung, um zu überprüfen, ob Aufgabe, Daten, Methoden und Bewertungskriterien den Anforderungen entsprechen.
- Überprüfen Sie, ob die Seiten des Papers Code, Datensätze, eine Projektseite oder Präsentationsfolien bieten.
- Es sollte vorrangig auf die endgültig veröffentlichte Version Bezug genommen werden, wobei Autor, Konferenz, Jahr und Digital Object Identifier überprüft werden müssen.
- Versionen der Veröffentlichung, der eingereichten Code-Dateien sowie der Daten werden aufgezeichnet, um eine spätere Wiederholung zu gewährleisten.
Wie man den Forschungskodier verwendet
- Finden Sie auf der Paper-Seite das entsprechende Repository und überprüfen Sie, ob es tatsächlich vom Autor oder vom Labor verwaltet wird.
- Lesen Sie die Anleitungsdokumente, Artikel, Lizenzen, Abhängigkeitsversionen und bekannte Probleme.
- Erstellen Sie eine isolierte Python-Umgebung und installieren Sie sie nicht direkt im Produktivsystem.
- Führen Sie zunächst das offizielle Mindestbeispiel oder die Tests aus, bevor Sie mit vollständigen Daten und Trainingsaufgaben beginnen.
- Feste Code-Übermittlung, zufällige Seed-Werte, Datenversionen und Hardwareumgebung.
- Vergleichen Sie Ihre Ergebnisse mit den Indikatoren der Veröffentlichung und notieren Sie die Unterschiede, die nicht reproduziert werden konnten.
- Bei der Veröffentlichung von Ableitungen ist gemäß der Lizenz und den wissenschaftlichen Richtlinien zu zitieren.
Prozess zur Wiederherstellung der Arbeit
- Es muss klar sein, ob die zu wiederholenden Ergebnisse die Trainingsergebnisse, die Bewertungsergebnisse, Diagramme oder qualitative Fallbeispiele sind.
- Überprüfen, ob die ursprünglichen Daten öffentlich zugänglich sind, ob eine Anmeldung erforderlich ist und ob eine erneute Verbreitung gestattet ist.
- Protokollieren Sie die Softwareumgebung, Treiber, Frameworks, Grafikkarte und den Zufallsseed.
- Zuerst wird die Datenerfassung und die Berechnung des Verlusts an einer kleinen Stichprobe überprüft.
- Überprüfen Sie in den Anhängen der Arbeit die Hyperparameter, die Vorbereitung der Daten, die Aufteilung der Daten sowie die Bewertungsprotokolle.
- Führen Sie es mindestens mehrmals aus und geben Sie den Durchschnitt, die Varianz sowie die Anzahl der Fehlschläge an.
- Unterscheiden Sie zwischen vollständiger Wiederherstellung, annähernder Wiederherstellung und Konzeptüberprüfung – übertreiben Sie die Übereinstimmung nicht.
Antrag auf Aufnahme in das Labor
Auf der offiziellen Website werden die Antragsverfahren für Postdoktoranden, Doktoranden, Praktika, Praktika in Laboren sowie für Bachelor- oder Masterarbeiten detailliert beschrieben. Das Team betont, dass es viele Anträge gibt und daher die vorgesehenen Antragsformulare verwendet werden sollten – anstelle davon, vollständige Anträge direkt per E-Mail zu senden.
- Lesen Sie die aktuellen Forschungstrends und wählen Sie ein Thema aus, das am besten zu Ihren persönlichen Erfahrungen passt.
- Erstellen Sie ein Lebenslauf, eine Forschungsbeschreibung, repräsentative Projekte sowie verifizierbaren Code oder wissenschaftliche Arbeiten.
- Beschreiben Sie das Problem, das gelöst werden soll, anstatt nur allgemeines Interesse an KI zu äußern.
- Es muss über die vorgesehenen Kanäle für Postdoktoranden-, Doktoranden- oder Studentenprojekte eingereicht werden.
- Überprüfen Sie den Anmeldeschluss, die Anforderungen an die Unterlagen sowie die Organisation der Empfehlungsschreiben.
- Warten Sie auf die offizielle Benachrichtigung – betrachten Sie die automatische Bestätigung nicht als Zulassung oder Vorstellungsgespräch.
Für welche Benutzer geeignet
- Forscher im Bereich Machine Learning: Auf der Suche nach Arbeiten zu kontinuierlichem Lernen, multimodalen Ansätzen und Modellbewertung.
- Forscher im Bereich der künstlichen Neuronenforschung: Suche nach Modellen für das visuelle System und neuronale Repräsentationen.
- Doktoranden und Masterstudenten: Suche nach Arbeiten, Daten, Replikationsprojekten und Bewerbungsmöglichkeiten.
- Ingenieur: Bewertung von Forschungstools wie Foolbox, ImageCorruptions usw.
- Modell-Sicherheitsteam: Forschung zu Robustheit gegen Angriffe und offenen Bewertungen.
- Forscher in den Bereichen Visuelle und Kognitive Wissenschaften: Verwendung von Ressourcen für die Analyse von Signifikanz, Augenbewegungen und Verhalten.
- Wissenschaftliche Unternehmer: Einblick in die Umsetzung von Forschungsergebnissen und aus Laboren hervorgehende Projekte.
Typische Anwendungsszenarien
- Etablierung von Literaturgrundlagen für kontinuierliches Lernen oder die Kombination von Generalisierungsfragen.
- Die Veröffentlichung nachbilden und den neuen Ansatz mit der öffentlich verfügbaren Laborkontrolle vergleichen.
- Verwenden Sie Werkzeuge für adversative Beispiele, um die Robustheit visueller Modelle zu bewerten.
- Verwendung des Bild-Erosions-Testmodells zur Beurteilung der Leistung unter Veränderungen der Verteilung.
- Untersuchung der wissenschaftlichen Zitierbarkeit und der Offenheit von Sprachmodellen.
- Vergleich der Vorhersagen der Maschinenvisualisierung mit menschlichen Augenbewegungs- oder Verhaltensdaten.
- Suchen Sie nach Möglichkeiten für Postdoktoranden, Doktoranden und Studenten zur Forschung.
Ressourcenvorteile
- Maschinelles Lernen und computergestützte Neurowissenschaften in einem gemeinsamen Forschungsrahmen zusammenbringen.
- Der Inhalt der Veröffentlichung umfasst einen langen Zeitraum und liefert vollständige Informationen zu Autoren und Verlagen.
- Auf vielen Artikelseiten werden gleichzeitig Code, Daten oder Projektanhänge bereitgestellt.
- Die GitHub-Organisation umfasst ausgereifte Tools sowie Implementierungen aus jüngsten Forschungsarbeiten.
- Die Forschungsschwerpunkte umfassen Modellbewertung, Agenten, multimodale Ansätze sowie visuelle und neuronale Daten.
- Einige Lager nutzen klare Lizenzen wie MIT oder Apache 2.0.
- Die offizielle Website zeigt klar die Teamzusammensetzung, das Netzwerk der Partner sowie die Anmeldeverfahren.
Einsatzbeschränkungen und Hinweise
- Das Bethge Lab ist ein Forschungsteam, kein SaaS-Tool, mit dem man tägliche Aufgaben direkt erledigen kann.
- Der Inhalt der offiziellen Website ist hauptsächlich auf Englisch, und für die Arbeiten sind Kenntnisse in maschinellem Lernen oder Neurowissenschaften erforderlich.
- Ein Teil des Codes gehört zu den Materialien zur Wiederherstellung der Veröffentlichung und weist möglicherweise nicht die Stabilität für produktive Zwecke auf.
- Die Lizenzen für verschiedene Lagerhäuser unterscheiden sich, und für einige Projekte gibt es keine klaren Standardlizenzen.
- Der Paper-Code kann auf ältere Frameworks, spezielle Hardware oder große Datenmengen angewiesen sein.
- Offene Modelle und Benchmarks können Datenverzerrungen, Verunreinigungen oder Probleme durch Lecks bei der Bewertung aufweisen.
- Projekte zur Erstellung von Adversarial Examples dürfen nur für autorisierte Tests, Lehrzwecke und Verteidigungsforschung verwendet werden.
- Vorabversionen und Konferenzversionen können sich von der endgültig veröffentlichten Fassung unterscheiden.
- Das Markieren im Lager, die Einreichungshäufigkeit und die Zitierungen der Artikel reichen allein nicht aus, um die Zuverlässigkeit der Methode zu belegen.
- Die Anmeldeseite sowie die Personendaten können sich ändern; es gilt der Stand der offiziellen Website zum Zeitpunkt der Einreichung.
Preise und Nutzungskosten
Die offizielle Website des Bethge-Labs, die Übersicht der Veröffentlichungen sowie die öffentlichen GitHub-Repositorien nutzen keine kommerziellen Abonnementmodelle. Das Lesen der Webseiten ist in der Regel kostenlos, doch der Zugang zu den vollständigen Artikeln, zu den Daten sowie zu Rechenressourcen für das Training und zu Diensten Dritter kann zusätzliche Kosten verursachen.
| Ressourcen | Offener Preis | Mögliche Kosten | Erklärung |
|---|---|---|---|
| Offizielle Website des Labors | Kostenloser Zugang | Netzkosten und Zeitkosten | Es ist nicht notwendig, ein Abo zu kaufen. |
| Inhaltsverzeichnis der Dissertation | Kostenloser Durchblick | Einige Publikationen können Zugangsbeschränkungen für Zeitschriften aufweisen. | Zuerst nach der offenen Version suchen |
| GitHub-Code | Öffentlicher Zugang | Rechenleistung, Speicher und Wartung | Befolgung der Lizenzen für die einzelnen Lager |
| Datensatz | Je nach Projekt | Antrags-, Download-, Speicher- und Konformitätskosten | Überprüfen Sie die Datennutzungsbedingungen |
| Antragsprojekt | Auf der offiziellen Website sind die Servicegebühren nicht aufgeführt. | Bildung, Visagebühren und Lebenshaltungskosten sind separat zu berechnen. | Die Zulassungsregeln werden von dem jeweiligen Programm festgelegt. |
Plattform und Zugangsmöglichkeiten
| Plattform | Unterstützungszustand | Verwendung |
|---|---|---|
| Web-Website | Unterstützung | Überblick über die Forschung, Artikel, Mitglieder und Antragsinformationen |
| GitHub | Unterstützung | Code, Datenbeschreibungen, Probleme und Versionshistorie |
| Windows | Je nach Projekt | Über den Browser oder in einer lokalen Forschungsumgebung verwenden |
| macOS | Je nach Projekt | Über den Browser oder in einer lokalen Forschungsumgebung verwenden |
| Linux | Die meisten Forschungscodes haben Vorrang. | Training, Bewertung und Reproduzierbarkeit |
| Mobile Version | Webseiten durchblättern | Das bedeutet nicht, eine eigenständige Mobile-App bereitzustellen. |
API, SDK und Open-Source-Status
Das Bethge-Lab verfügt weder über eine einheitliche kommerzielle API noch über eine Account-Konsole oder ein allgemeines SDK. Die Möglichkeiten im Bereich Open Source sind in separaten Forschungsrepositorien vorhanden; die Nutzer müssen entsprechend den Veröffentlichungen Projekte auswählen und sich an die Lizenzen dieses Repositoriums sowie an die Lizenzen für seine Daten, Modelle und Abhängigkeiten halten.
Das Labor selbst ist kein als Ganzes installierbares Open-Source-Produkt, doch ein großer Teil des Forschungscodes ist öffentlich zugänglich. Der Open-Source-Status im Verzeichnis lässt sich besser als „teilweise open source für Forschungscode“ bezeichnen; man kann nicht einfach behaupten, dass alle Ergebnisse unter derselben Lizenz stünden.
Sicherheit und Forschungsethik
- Gegenbeispiele und Modellangriffe dürfen nur auf autorisierten Systemen eingesetzt werden.
- Daten zu Nerven, Verhalten und Augenbewegungen können Forschungen am Menschen sowie Datenschutzbeschränkungen betreffen.
- Prüfen Sie vor dem Herunterladen der Daten die ethischen Genehmigungen, den Umfang der Zustimmung sowie die Bedingungen für die Weiterverbreitung.
- Bei der Bewertung großer Modelle sollten Prompt-Wörter, Modellversionen, Temperatur sowie das Risiko einer Datenverunreinigung erfasst werden.
- Wissenschaftliche Code sollte in einer isolierten Umgebung ausgeführt werden, wobei Abhängigkeiten und Dateioperationen überprüft werden müssen.
- Ergebnisse der Erstellung oder Bewertung können keine Ersatz für Peer-Review und unabhängige Überprüfung sein.
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name | Bethge Lab |
| Eigenschaften | Forschungsteam für maschinelles Lernen und computergestützte Neurowissenschaften an der Universität |
| Verantwortliche Person | Matthias Bethge |
| Zugehörige Institution | Universität Tübingen |
| Hauptrichtung | Lebenslanges Lernen, Modellbewertung, Agenten, neuronale Repräsentationen und visuelle Aufmerksamkeit |
| Preismuster | Die offizielle Website sowie der öffentliche Code sind kostenlos zugänglich – es ist keine kommerzielle Mitgliedschaft erforderlich. |
| Ist eine Registrierung erforderlich? | Es ist nicht notwendig, die offizielle Website zu besuchen; Drittanbieter-Ressourcen könnten hingegen erforderlich sein. |
| Einheitliche API | Kein |
| Einheitliches SDK | Kein |
| GitHub | Es gibt Organisationen mit demselben Namen sowie Dutzende öffentlicher Lagerhäuser. |
| Open-Source-Zustand | Der Forschungskodeteil ist teilweise open source; die Lizenz variiert je nach Repository. |
| Hauptsprache | Englisch |
Empfehlungswert
Der Gesamtbewertungswert beträgt 4,4 von 5 Punkten. Für Forscher im Bereich maschinelles Lernen, computergestützte Neurowissenschaften und Bewertung von Modellen bietet das Bethge Lab eine Übersicht über Artikel mit zusammenhängendem Themenspektrum sowie umfangreiche Code-Ressourcen.
Es eignet sich nicht für normale Benutzer, die eine einfache AI-Suche, Schreibfunktionen oder Bürodienste suchen. Forscher müssen zudem die Kosten für die Auswahl von Artikeln, die Einrichtung der Umgebung, die Überprüfung von Lizenzen sowie die Durchführung von Experimenten tragen.
Häufige Fragen
Was ist das Bethge-Lab?
Es handelt sich um das Forscherteam für KI und computergestützte Neurowissenschaften an der Universität Tübingen, nicht um eine kommerzielle KI-Anwendung.
Kann das Bethge-Lab direkt online genutzt werden?
Es ist möglich, Forschungsarbeiten und Artikel anzusehen, es gibt jedoch kein einheitliches Tool zur Erstellung im Online-Bereich. In der Praxis ist es in der Regel notwendig, auf den entsprechenden Code-Repository zuzugreifen und die Forschungsumgebung einzurichten.
Ist ein Besuch der offiziellen Website kostenpflichtig?
Für die offizielle Website und den öffentlichen Code ist keine Abonnementgebühr erforderlich; für Publikationen, Cloud-Rechenleistung sowie bestimmte Daten können jedoch weitere Kosten anfallen.
Welche sind die wichtigsten Forschungsbereiche?
Dazu gehören die Bewertung von offenen Modellen, Sprachmodell-Agenten, lebenslanges kombiniertes Lernen, neuronale Repräsentationen, menschliche und künstliche Aufmerksamkeit sowie AI-Wissenschafts-Unternehmertum.
Ist das Bethge-Lab Open Source?
Das gesamte Labor kann nicht als Open-Source-Produkt bezeichnet werden, doch die GitHub-Organisation stellt eine große Menge an Forschungskodier zur Verfügung.
Können alle Lagerhäuser für kommerzielle Zwecke genutzt werden?
Man kann nicht pauschal urteilen; für jeden Lagerplatz, jedes Datensatz, jedes Modell sowie jede Abhängigkeit müssen die Lizenzen und Nutzungsbedingungen einzeln überprüft werden.
Wofür eignet sich Foolbox?
Eignet sich zur Erstellung von Adversarial Examples in einer autorisierten Umgebung und zur Bewertung der Robustheit von neuronalen Netzen.
Wird eine einheitliche API bereitgestellt?
Nein, die öffentlichen Ressourcen bestehen hauptsächlich aus unabhängigen Paper-Projekten, Python-Paketen, Notebooks und Datensätzen.
Wird Chinesisch unterstützt?
Die offizielle Website und die meisten Artikel sind hauptsächlich auf Englisch verfasst. Ein Teil des Codes kann für mehrsprachige Forschungen verwendet werden, es gibt jedoch keine Garantie für eine chinesische Benutzeroberfläche.
Wie findet man den Code zu einer wissenschaftlichen Veröffentlichung?
Überprüfen Sie im Inhaltsverzeichnis oder auf der Detailseite der Veröffentlichung Anhänge wie Code, Datensätze und Projekte und prüfen Sie anschließend den Repository-Autor sowie die Informationen zur Veröffentlichung.
Kann man sich um eine Zulassung zum Labor bewerben?
Es ist möglich, über die auf der offiziellen Website bereitgestellten Kanäle für Postdoktoranden-, Doktoranden- und Studentenprogramme zu bewerben. Die genauen Öffnungszeiten sowie Fristen können sich ändern.
Eignet es sich für Anfänger?
Die offizielle Website eignet sich, um sich über die Forschungsschwerpunkte zu informieren, doch die meisten Artikel und Nachahmungsprojekte erfordern Kenntnisse in Python, tiefenliegender Lernalgorithmen, Statistik oder Neurowissenschaften.
Werkzeuge, die denen des Bethge-Labs ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164