




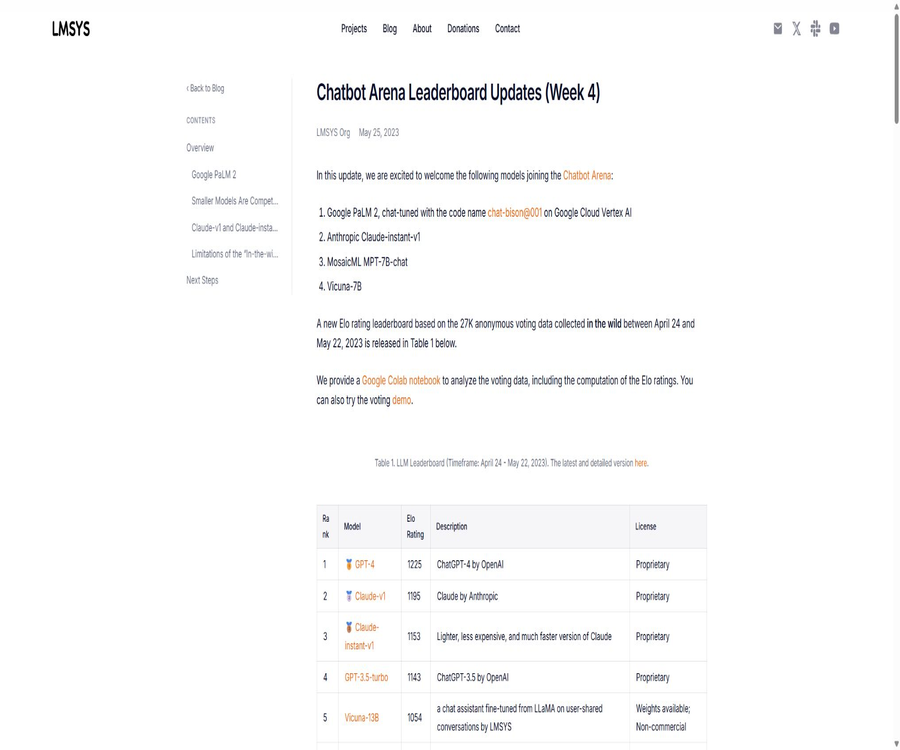
Chatbot Arena Leaderboard
Chatbot Arena Leaderboard – ein intelligentes Tool zur Bewertung von KI-Modellen
Tags:Bewertung von KI-ModellenWas ist Arena AI?
Arena AI ist eine Plattform, die generative KI-Modelle durch anonyme Vergleiche mit echten Nutzern bewertet. Sie geht auf Chatbot Arena und LMArena zurück. Wenn Nutzer denselben Prompt eingeben, erhalten sie Antworten von zwei anonymen Modellen, und sie können per Abstimmung das bessere Ergebnis auswählen.
Das Projekt wurde ursprünglich von LMSYS und Forschern der University of California, Berkeley, ins Leben gerufen und entwickelte sich später zu einer eigenständigen Plattform. Die aktuelle offizielle Marke wurde auf Arena vereinfacht; die alte LMSYS-Blogseite dient nur noch zum Verständnis der Geschichte und sollte nicht länger als Hauptzugang zum Produkt genutzt werden.
Die Beziehung zwischen Chatbot Arena, LMArena und Arena
| Name | Phasen und Bedeutung | Aktuelle Nutzungsempfehlungen |
|---|---|---|
| Chatbot Arena | Name des ursprünglichen Forschungsprojekts, das im Jahr 2023 begann | Für Aufsätze, historische Einführungen und frühe Open-Source-Code-Beispiele |
| LMArena | Markenname in der Phase von eigenständigen Websites und Unternehmen | Wird weiterhin von vielen Medien und Nutzern verwendet |
| Arena | Derzeitige einheitliche Marke | Offizielle Website, Ranglisten und Produktbeschreibungen haben Vorrang. |
| LMSYS | Akademische Organisationen, die frühe Forschungen initiierten | Kann nicht vollständig mit dem aktuellen Unternehmen Arena und all seinen Produkten gleichgesetzt werden. |
Wie funktioniert Arena?
- Wählen Sie Text, Bilder, Videos, Code oder etwas anderes aus, das für die Aufgabe geeignet ist.
- Geben Sie einen echten Prompt ein, der die Fähigkeiten des Modells unterscheiden kann.
- Die Plattform stellt zufällig zwei anonyme Modelle bereit und erzeugt gleichzeitig die Ergebnisse.
- Vergleichen Sie die beiden Seiten hinsichtlich Genauigkeit, Hilfreichkeit, Stil und Erfüllungsgrad der Aufgabe.
- Wählen Sie: A ist besser, B ist besser, Unentschieden oder beides ist schlecht.
- Nach dem Einreichen der Abstimmung die wahre Identität des Modells ansehen.
- Setzen Sie das Gespräch fort oder beginnen Sie eine neue Runde, um die Präferenzdaten in ein öffentliches Bewertungssystem aufzunehmen.
Kernfunktionen
1. Anonyme Modell-Kämpfe
Im Battle-Modus werden die Namen der Modelle vor der Abstimmung verdeckt, um die Bekanntheit der Marken sowie die Vorurteile der Nutzer zu verringern. Die Antworten selbst können dennoch den Stil des Modells offenbaren; daher kann das Anonymisierungsverfahren nur Vorurteile verringern, sie aber nicht vollständig beseitigen.
2. Menschliche Präferenzen bei der Stimmabgabe
Die Plattform verlässt sich nicht auf feste Standardantworten, sondern lässt echte Nutzer entscheiden, welche Ergebnisse nützlicher sind. Sie eignet sich besonders gut zur Bewertung von Aufgaben wie Schreiben, Dialogen, Bildern sowie für offene Aufgaben, die sich nicht mit einer einzigen Zahl bewerten lassen.
3. Mehrspur-Rankingliste
Arena hat sich von reinen Textchats auf Bilder, Videos, Code, visuelle Inhalte und weitere spezielle Bereiche erweitert. Die Eingabedaten, die verfügbaren Modelle sowie die Bewertungskriterien unterscheiden sich in den verschiedenen Kategorien, weshalb die Ranglisten nicht direkt miteinander verglichen werden können.
4. Direktemodus
Neben anonymen Kämpfen können die Nutzer auch direkt bekannte Modelle zum Testen auswählen. Der Direct-Modus eignet sich zur Überprüfung bestimmter Modelle, doch nur Stimmen, die den Regeln der anonymen Bewertung entsprechen, sollten die Rangliste beeinflussen.
5. Offene Forschung und Datensätze
Arena veröffentlicht wissenschaftliche Artikel, Analysen sowie aufbereitete Datensätze zu menschlichen Präferenzen zur Erforschung von Modellbewertungen, adversativen Angriffen, übermäßigem Ablehnen und Suchfähigkeiten. Die öffentlich zugänglichen Daten unterliegen eigenen Datenschutzbestimmungen und Lizenzen und dürfen nicht als vollständige, ursprüngliche Plattformdaten angesehen werden.
Übersicht der Hauptfunktionen
- Lassen Sie zwei anonyme AI-Modelle zur gleichen Aufgabe antworten und vergleichen Sie sie nebeneinander.
- Stimmenmöglichkeiten für Sieg, Unentschieden und beides sind möglich.
- Nach der Abstimmung wird die Identität des Modells offenbart, um Vorurteile gegenüber der Marke vor der Abstimmung zu verringern.
- Ständig aktualisierte Ranglisten für Texte, Bilder, Videos und Code.
- Überprüfen Sie die Leistung der Modelle nach Kategorie, Sprache oder Aufgabe in detaillierter Form.
- Wählen Sie direkt ein bestimmtes Modell aus, um es auszuprobieren und die Ergebnisse zu überprüfen.
- Testmodelle, die noch nicht offiziell veröffentlicht wurden oder unter einem Codenamen vorliegen.
- Öffentliche Daten zu menschlichen Präferenzen, wissenschaftliche Arbeiten und Bewertungsmethoden.
- Die zusammengefassten Rückmeldungen der Gemeinschaft werden genutzt, um die Entwickler des Modells dabei zu unterstützen, das Produkt zu verbessern.
Wie versteht man die Punktzahlen in der Rangliste?
Arena fasst zahlreiche Paarvergleiche von Siegen und Niederlagen zu einer Rangliste der relativen Fähigkeiten zusammen. Dabei werden in der Regel statistische Modelle für Paarvergleiche wie Bradley-Terry verwendet, wobei zur Schätzung der Unsicherheit auch Resampling-Methoden eingesetzt werden. Die Nutzer bezeichnen die Ergebnisse oft als Elo-Werte, doch die genaue Berechnungsmethode sollte gemäß den Vorgaben der Rangliste festgelegt werden.
| Indikatoren oder Konzepte | Was steht darunter? | Das sagt nichts aus. |
|---|---|---|
| Arena Score | Die relative Präferenzstärke des Modells in den aktuellen Abstimmungsdaten | Nicht die absolute Genauigkeit oder der allgemeine Intelligenzquotient. |
| Rank | Die Position unter Berücksichtigung der festgelegten Ranglisten und Statistikregeln | Es kann nicht garantiert werden, dass es im echten Geschäftsbetrieb besser sein wird. |
| Konfidenzintervall | Unsicherheit bezüglich der Rangfolge und der Punktzahlen | Bei überschneidenden Intervallen sollte man keine großen Unterschiede in den Rängen betonen. |
| Anzahl der Stimmen | Größe der für die Schätzung verwendbaren Kampfbeispiele | Eine große Anzahl bedeutet nicht, dass die Stichprobe keinen Verzerrungen aufweist. |
| Klassifikationsliste | Die relative Leistung des Modells bei bestimmten Aufgaben oder in bestimmten Sprachen | Kann die Aufgabe, eigene Tests zu erstellen, nicht ersetzen. |
Wie man effektive Kontrasthinweise gestaltet
- Wählen Sie aus Ihren eigentlichen Aufgaben ein konkretes Problem aus, anstatt nur allgemeine Fragen zu stellen.
- Geben Sie den notwendigen Hintergrund, die Eingabedaten, die Einschränkungen sowie das gewünschte Ausgabeformat an.
- Vermeiden Sie die Einbeziehung von persönlichen Daten, Geschäftsgeheimnissen und nicht veröffentlichten Materialien.
- Lassen Sie die beiden Modelle dieselbe Aufgabe erledigen, ohne die Bewertungskriterien unterwegs zu ändern.
- Zuerst werden die Fakten, die Schlussfolgerungen und die Einhaltung der Anweisungen unabhängig überprüft, anschließend wird der Ausdrucksstil verglichen.
- Wenn es schwierig ist, eine Entscheidung zu treffen, sollte man auf Unentschieden oder „beides ist gleich schlecht“ zurückgreifen – es ist nicht notwendig, unbedingt einen Sieger zu ermitteln.
- Für kritische Aufgaben werden mehrere verschiedene Proben wiederholt, anstatt die Wahl auf einen einzigen Kampf zu stützen.
Für welche Benutzer geeignet
- Normale AI-Nutzer, die verschiedene fortschrittliche Modelle ausprobieren möchten.
- Entwickler, die über grundlegende Fähigkeiten in der Modellierung, im logischen Denken, in der Programmierung sowie in visuellen Aufgaben verfügen, sind erforderlich.
- Wissenschaftler, die Methoden zur Messung von menschlichen Vorlieben und zur Sortierung von Modellen erforschen.
- Branchenbeobachter, die die relative Leistung neuer Modelle im Vergleich zu Vorab-Modellen verfolgen.
- Es sind externe Referenzen sowie Produkt- und Technikteams erforderlich, um die Modellwahl zu treffen.
- Laboratorien und Hersteller, die hoffen, das Modell durch echte Nutzerfeedbacks zu verbessern.
- Prüfer, die Angriffe auf Ranglisten, Vorurteile und die statistische Zuverlässigkeit untersuchen.
Verschiedene Arenen und Anwendungsgebiete
- Textdialog: Vergleich von Wissen, Schlussfolgern, Kreativität und Befolgung von Anweisungen.
- Code: Vergleich der Codegenerierung, -korrektur, der Implementierung der Benutzeroberfläche und der Nutzung von Tools.
- Bild: Vergleich von Text-basierten Bildgenerierung, Bearbeitung und Einhaltung von Prompten.
- Video: Vergleich der Qualität und Kohärenz von Videos, die aus Texten oder Bildern erstellt werden.
- Visuelle Verständnis: Vergleich von Bild-Frage-Antwort-, Diagramm-, OCR- und multimodalem Reasoning.
- Suche und Recherche: Vergleich von Suchergebnissen, Zitaten, Aktualität und umfassenden Antworten.
- Spezifische Sprachen: Beobachtung der relativen Präferenzen des Modells für Chinesisch und andere Sprachen.
Kostenlos und Anmeldeanforderungen
Arena bietet der Öffentlichkeit kostenlosen Zugang zu Modellkämpfen und Ranglisten. Es gibt keine kostenpflichtigen Pakete für normale Nutzer. Verschiedene Modelle können Unterbrechungen in der Nutzung, Geschwindigkeitsbeschränkungen, regionale Einschränkungen sowie Limits bezüglich des Anmeldens oder der täglichen Nutzung aufweisen. Zudem kann die Plattform ihre Kapazitäten anpassen.
| Funktionen | Preis | Konten und Einschränkungen |
|---|---|---|
| Die Rangliste ansehen | Kostenlos | Normalerweise kann man direkt darin blättern. |
| Anonyme Modell-Kämpfe | Kostenlos | Es kann sein, dass ein Anmelden erforderlich ist und es Limits hinsichtlich der Geschwindigkeit oder der Kapazität gibt. |
| Direkte Modelle-Experience | Kostenlos | Die verfügbaren Modelle und Anzahl der Durchführungen können sich ändern. |
| Forschungsdatensätze | Nach Eröffnung der entsprechenden Seite | Es müssen die Lizenzen und Nutzungsbedingungen des Datensatzes eingehalten werden. |
| Modellhersteller-Bewertungskooperation | Kein offizieller einheitlicher Preis | Alleinige Koordination durch Arena und Partner |
Wie man Modelle richtig mithilfe der Rangliste auswählt
- Wählen Sie zunächst die Sparte, die Sprache und die Kategorieliste aus, die am nächsten zum Geschäftsfeld liegen.
- Betrachten Sie die Scores und Konfidenzintervalle – schauen Sie nicht nur auf den Erstplatzierten und die geringen Unterschiede in den Rängen.
- Stellen Sie sicher, dass die Modellversion in der Rangliste mit der tatsächlich erhältlichen Version übereinstimmt.
- Filterung unter Berücksichtigung von Kosten, Verzögerungen, Kontext, Datenrichtlinien und Implementierungsweise.
- Erstellen Sie ein internes Testset mit echten Geschäftsdaten.
- Es werden getrennt voneinander die Fakten, der Code, die Sicherheit, die Aufrufe von Tools sowie die strukturierte Ausgabe getestet.
- Nach dem Go-Live wird die Aktualisierung des Modells sowie die Kundenfeedbacks kontinuierlich überwacht.
Vorteile der Rangliste
- Die Verwendung offener Anweisungen mit echten Nutzern kommt der täglichen Erfahrung näher als statische Prüfungen.
- Die anonyme Präsentation verringert bestimmte Markenvoreingenommenheiten und den Einfluss des Rufs des Modells.
- Paarvergleiche machen es einfacher zu beurteilen, da die Benutzer absolute Punktzahlen angeben müssen.
- Modelle und Abstimmungen werden ständig aktualisiert, um schnell die Leistung der neuen Versionen widerzuspiegeln.
- Deckt Texte, Bilder, Videos, Code und multimodale Bereiche ab.
- Offene Forschung, Methoden und Teildaten ermöglichen eine externe Überprüfung.
- Kleine Labore dürfen unter demselben Mechanismus wie große Hersteller Nutzerbewertungen erhalten.
Einsatzbeschränkungen und Methodenfehler
- Wähler und Hilfestellungen stammen von frei gewählten Nutzern und können nicht alle Länder, Branchen und Bevölkerungsgruppen repräsentieren.
- Benutzer bevorzugen möglicherweise längere, selbstbewusstere oder stilvollere Antworten statt präzisere.
- Anonyme Modelle können dennoch durch Formulierungen, Formatierung und Stil der Ablehnung identifiziert werden.
- Die Rangliste ist eine relative Sortierung; Veränderungen im Modellpool und in der Kampfdistribution beeinflussen die Punktzahlen.
- Kleine Unterschiede in den Rängen haben möglicherweise keine statistische Bedeutung und sollten im Zusammenhang mit den Konfidenzintervallen interpretiert werden.
- Die Vorschauversion des Modells kann in Bezug auf Hinweise, Stichproben oder Einstellungen von der veröffentlichten Version abweichen.
- Böswillige Abstimmungen, koordinierte Angriffe und Datenverunreinigungen erfordern eine kontinuierliche Absicherung.
- Allgemeine menschliche Präferenzen können die Bewertung von medizinischen, rechtlichen, sicherheitstechnischen und unternehmerischen Aufgaben nicht ersetzen.
Privatsphäre und Einreichung von Inhalten
Offiziell wird mitgeteilt, dass die von den Nutzern eingereichten Anmerkungen gesammelt werden, um eine faire und transparente Bewertung zu ermöglichen. Ein Teil der Rückmeldungen kann außerdem an die Entwickler des Modells weitergegeben werden. Die Nutzer sollten Arena als öffentliches Forschungs- und Bewertungsumfeld betrachten und nicht als privates Chatwerkzeug für die Verarbeitung vertraulicher Daten.
- Geben Sie keinen Namen, keine Kontaktdaten, keine Account-Informationen, kein Passwort und keine Identitätsdaten ein.
- Fügen Sie keine internen Firmencodes, Kundendaten oder nicht veröffentlichte Dokumente ein.
- Für Bilder und Videos dürfen nur Materialien verwendet werden, die man selbst besitzt oder für die man eine Genehmigung hat.
- Für Probleme in sensiblen Branchen sollten synthetische oder geminderte Proben verwendet werden.
- Überprüfen Sie vor der Abstimmung, ob die Antworten sensible Inhalte aus den Eingaben preisgeben.
- Beim Einsatz öffentlicher Datensätze müssen die Regeln zur Datenschutzfilterung, zu Lizenzen und zur Weiterverbreitung eingehalten werden.
Open-Source-Projekte und Datensätze
Die frühe Version von Chatbot Arena basierte auf der Plattform LMSYS FastChat. FastChat wird unter der Apache-2.0-Lizenz bereitgestellt und bietet Dienste für verschiedene Modelle, eine Web-Oberfläche sowie Code zur Bewertung. Die heutige Arena-Plattform verfügt über weitere spezielle Funktionen sowie kommerzielle Einsatzmöglichkeiten – die ursprüngliche Version kann daher nicht vollständig als Abbild der aktuellen Plattform dienen.
- FastChat enthält einen Modell-Service, eine Dialogoberfläche und eine frühe Implementierung von Arena.
- Arena veröffentlicht auf Plattformen wie Hugging Face die verarbeiteten Daten zu menschlichen Präferenzen.
- In den entsprechenden Artikeln werden anonyme Paarabstimmungen sowie Methoden zur Sortierung vorgestellt.
- Visuelle Aspekte, Suchfunktionen, übermäßige Ablehnung sowie Angriffe auf Ranglisten werden jeweils eigens erforscht.
- Offener Quellcode, Forschungsdaten und Online-Plattformen sind drei unterschiedliche Bereiche.
- Der ursprüngliche GitHub-Link für StableLM in der Datenbank hat nichts mit dem Arena-Projekt zu tun und sollte nicht als offizielle Quelldatei verwendet werden.
Warum kann man nicht nur auf die Arena-Rangliste schauen?
- Betriebskosten und Verzögerungen fließen nicht in die allgemeine Präferenzbewertung ein.
- Die Datenaufbewahrung, Privatsphäre, Konformität und Lieferbedingungen müssen separat bewertet werden.
- Strukturierte Ausgaben, Toolaufrufe und Langzeitteststabilität können an ausreichenden Beispielen mangeln.
- Die Anzahl der Hinweise für spezifische Branchen im Chinesischen kann geringer sein als bei allgemeinen Englisch-Aufgaben.
- Nach dem Update des Modells kann es zu einer vorübergehenden Diskrepanz zwischen der Version der Rangliste und der tatsächlichen API-Version kommen.
- Hochriskante Aufgaben erfordern umso mehr reproduzierbare Tests und Expertenprüfungen.
Plattform und Open-Source-Zustand
| Projekt | Aktuelle Situation |
|---|---|
| Der aktuelle Name | Arena AI, früherer Name LMArena und Chatbot Arena |
| Produktform | Webseiten-Modell-Kämpfe, direkte Erfahrung und öffentliche Ranglisten |
| Preis | Die öffentlichen Funktionen sind kostenlos – es gibt keine kostenpflichtigen Pakete für normale Nutzer. |
| Entwickler-API | Es wird keine einheitliche API für das Modell-Reasoning für normale Benutzer bereitgestellt. |
| Frühe Open-Source-Projekte | LMSYS FastChat, Lizenz Apache-2.0 |
| Offene Daten | Veröffentlichung des nach der Verarbeitung bereitgestellten Datensatzes zu menschlichen Präferenzen sowie des Forschungspapiers |
| Ist es insgesamt open source? | Nein, die aktuelle vollständige Plattform ist nicht gleich dem früheren FastChat-Repository. |
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name des Tools | Arena AI |
| Historischer Name | LMArena, Chatbot Arena |
| Ursprung | LMSYS und Forschungsprojekte der University of California, Berkeley |
| Arten von Werkzeugen | Blinde Tests für KI-Modelle, Ranglisten und Plattformen für die Bewertung unter Berücksichtigung menschlicher Vorurteile |
| Kernmechanismus | Anonyme Paar-Kämpfe und Nutzerabstimmungen |
| Überlappende Modi | Texte, Bilder, Videos, Code und multimodale Inhalte |
| Preismuster | Kostenlos |
| Wird eine Reasoning-API bereitgestellt? | Nein |
| Ob Open Source | FastChat wurde ursprünglich unter Open Source veröffentlicht; die aktuelle Plattform ist nicht vollständig open source. |
Empfehlungswert
4,7 / 5. Arena AI ist eine wichtige Referenz, um die tatsächlichen Präferenzen und Erfahrungen echter Nutzer sowie die Leistungsfähigkeit neuer Modelle zu beurteilen. Anonyme Wettkämpfe sowie öffentliche Untersuchungen haben einen besonderen Wert. Doch die Ranglisten stellen keine objektiven, umfassenden Bewertungen dar. Bei der Auswahl eines Modells müssen interne Anforderungen, Kosten, Sicherheitsaspekte sowie Anforderungen an die Implementierung berücksichtigt werden.
Häufige Fragen
Sind LMArena und Chatbot Arena derselbe Plattform?
Sie gehören zur gleichen Entwicklungsphase eines Projekts; die derzeitige Marke ist Arena. Chatbot Arena war der ursprüngliche Name, LMArena ist eine später entstandene eigenständige Marke.
Ist Arena AI kostenlos?
Öffentliche Kämpfe, die Direktnutzung sowie die Ranglisten sind derzeit kostenlos, doch die Verfügbarkeit der Modelle, die Wartezeiten sowie die Anzahl der Nutzungsmöglichkeiten können je nach Kapazität angepasst werden.
Kann man vor der Abstimmung den Namen des Modells sehen?
Im Battle-Modus wird die Identität nicht angezeigt; sie wird erst nach Abgabe der Stimme offenbart. Im Direct-Modus können die Nutzer direkt bekannte Modelle auswählen.
Ist das Modell auf Platz eins der Rangliste das beste?
Nicht unbedingt. Die Rangliste spiegelt die relativen Präferenzen unter einer bestimmten Verteilung von Nutzern und Anweisungen wider; bei der tatsächlichen Auswahl müssen außerdem Genauigkeit der Aufgabe, Kosten, Verzögerungen, Privatsphäre und Implementierung berücksichtigt werden.
Bietet Arena eine Modell-API an?
Es gibt keine einheitliche Produktionsschließung-API für gewöhnliche Entwickler. Sie wird hauptsächlich für das Erleben, den Wettkampf und die Bewertung verwendet und ist keine Plattform zur Aggregation von Modellen.
Ist Arena Open Source?
Früher war FastChat sowie ein Teil der Forschungsdaten öffentlich zugänglich, doch die aktuelle vollständige Arena-Website, alle Wettkampfkategorien und das Betriebssystem können nicht als ganzheitlich open source angesehen werden.
Werkzeuge, die der Chatbot Arena Leaderboard ähneln


 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164