




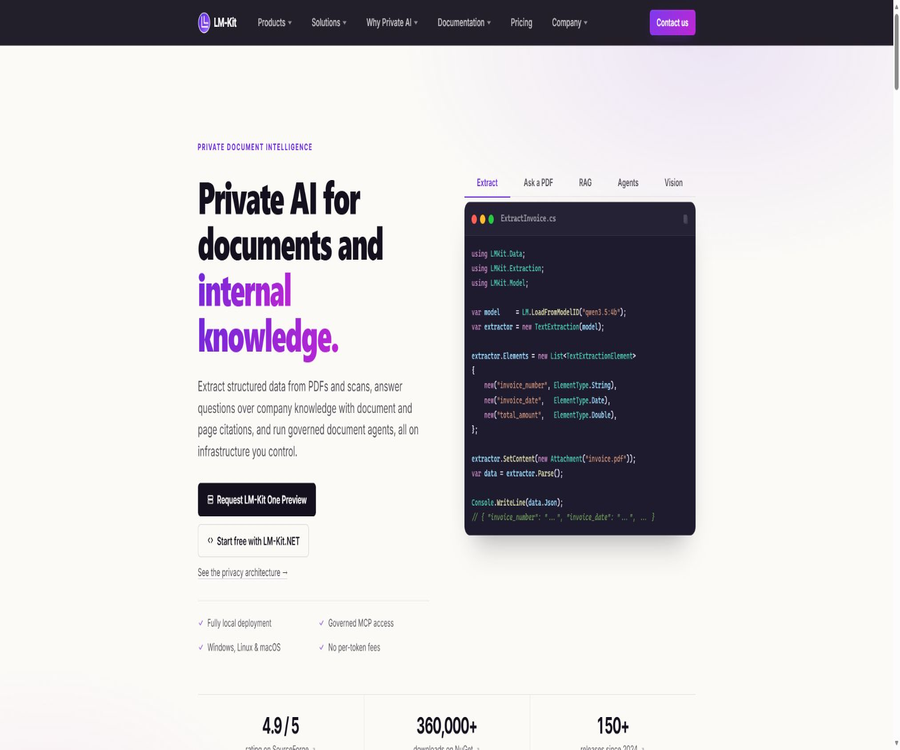
LM-Kit 是什么
LM-Kit 是一套在用户自有基础设施中处理文档、知识和智能体任务的私有 AI 平台,核心形态包括可嵌入 .NET 应用的 LM-Kit.NET 和可独立部署的 LM-Kit One。
它主要解决合同、发票、理赔、政策、人事文件等敏感资料不宜上传公有云的问题,同时让结构化字段带信心度、问答带页码与原文片段。
两种产品形态
| 产品 | 使用方式 | 主要接口 | 核心能力 | 适合用户 |
|---|---|---|---|---|
| LM-Kit.NET | 以 NuGet 包嵌入进程 | .NET API、Microsoft.Extensions.AI、Semantic Kernel、MCP | 本地推理、文档、RAG、视觉、语音、智能体与微调 | .NET 软件开发商与嵌入式产品 |
| LM-Kit One | 在企业环境中部署独立服务 | REST、OpenAI 兼容接口、Ollama、Anthropic、MCP | 管理控制台、文档集合、搜索、模型管理、审批工具与请求记录 | 企业 AI 与文档团队 |
LM-Kit One 当前处于 Business Preview,预览期内接口可能变更,长期支持版本计划在正式发布后提供。
主要功能
文档解析与结构化提取
- 读取 PDF、DOCX、PPTX、XLSX、EML、HTML、图像和扫描件,在原生文本提取与视觉 OCR 之间按页面选择路径。
- 按用户定义的结构返回可解析 JSON,每个字段带信心度和人工审核标记,适合发票、合同、表单和证件抽取。
- 对长 PDF 识别文档边界并自动拆分,还可进行合并、搜索、渲染、解锁、表单填写和 PDF/A 归档转换。
- 检测文本、图像和 Office 文档中的个人信息,由审核者确认后执行永久脱敏,而非只在视觉上覆盖。
RAG、搜索与可核查问答
- 将政策、手册、合同和内部维基建立为文档集合,支持全文、向量和混合检索及重排。
- 回答同时返回文档、页码和支持该结论的原文片段,文档未提供答案时应显式返回无依据结果。
- 内置存储可直接起步,也可连接 Qdrant 或 PostgreSQL pgvector,并通过统一向量存储接口替换实现。
智能体、多模态与本地模型
- 智能体支持 ReAct、计划后执行、并行、管道、主管和图形编排,工具调用可设置允许、禁止、风险级别与审批门。
- 支持文本生成、图像理解、OCR、嵌入、分类、实体识别、情感分析与 Whisper 系列本地语音转文字。
- 可从策展模型卡下载开放权重模型,也可加载自有 GGUF;还支持 LoRA 微调、量化、多 GPU 拆分和加密模型加载。
- 模型可在 CPU、AVX2、CUDA 12/13、Vulkan 或 Metal 上运行,适用 Windows 10 以上、Linux x64 与 ARM64、macOS。
使用教程
- 根据架构选择在 .NET 应用内嵌入 LM-Kit.NET,或部署 LM-Kit One 作为共享私有服务。
- 评估操作系统、CPU、内存和 GPU,从能在目标硬件上稳定运行的较小模型开始。
- LM-Kit.NET 通过 NuGet 安装主包和与硬件匹配的可选加速包,并在应用启动时仅初始化一次运行时。
- 为文档流程定义提取结构、人工审核阈值、检索库、模型、工具权限和外部网络访问策略。
- 用固定测试集验证提取字段、OCR、问答引用、工具调用、失败退路和敏感数据边界后再上线。
- 在生产环境记录模型、提示、结构版本、请求轨迹和人工审批,并按发布说明回归测试。
价格与许可
| 套餐或版本 | 价格 | 计费周期 | 核心权益或额度 | 适合用户 |
|---|---|---|---|---|
| Free | $0 | 无到期日 | 完整 SDK 与服务器,允许符合门槛的公司商用和再分发;个人、教育、非营利与开源项目始终免费 | 小团队、个人、教育和评估项目 |
| Professional | 定制报价 | 年度许可 | 大规模商用与再分发、长期支持构建、安全补丁、响应时间承诺,开发者和终端用户数不限 | 超出免费门槛的商业部署 |
免费商用要求公司年度总收入低于 100 万美元、员工不超过 10 人,且外部融资不超过 300 万美元,并需在产品页明确标注 LM-Kit.NET。
评估和开发对任何规模公司均免费且无时限,超出门槛后的生产使用需要 Professional 许可。
商业报价根据公司规模、部署范围、嵌入 LM-Kit 的独立商业产品数和支持级别制定,不按令牌、席位或终端用户计费。
通过产品网站或授权经销商购买的 Professional 年度订阅及多应用许可包,可在原始购买日起 30 天内凭购买证明申请退款;企业协议还要以合同约定为准。
API、GitHub 与开源区分
- LM-Kit.NET 提供完整 .NET API 与文档,LM-Kit One 提供 REST、多种兼容接口和 MCP,但产品运行时与服务器本体采用 LM-Kit 商业许可,不等于开源软件。
- 官方示例仓库、Semantic Kernel、Microsoft.Extensions.AI、数据连接器和 AWS 集成仓库主要采用 Apache-2.0,但这些示例与连接器的开源状态不会改变主产品许可。
- Maestro 桌面应用采用 MIT 许可,LynxTranscribe 语音转文字应用采用 GPL-3.0,两者都应按自己的仓库许可处理,不应推导 LM-Kit 平台本体开源。
- 策展中的开放权重模型拥有各自的发布方许可,LM-Kit 许可不覆盖模型权重的商业使用条件。
隐私与安全架构
- 完全本地模式中,在关闭外部工具和可选遥测且模型已存在于主机的前提下,文档、提示、嵌入和输出可留在本机。
- 外部助手通过 MCP 调用本地工具时,原始文档、OCR 和索引仍可留在本地,但工具返回结果会披露给外部模型,管理员必须审核可用工具与返回内容。
- LM-Kit One 初始默认仅绑定本机,网络访问需显式开启;API 密钥以哈希形式保存,会话与可访问文件绑定到已认证所有者。
- 模型、索引、上传文件、缓存、日志和请求历史保存在可配置的本地状态目录或指定数据库中,日志保留时间可配置。
- 网站可收集用户主动提交的姓名、邮箱与账户信息,也会处理 IP、浏览器、跳转页面和访问统计;用户可请求删除,离线副本再保留一个月后永久删除。
优势与使用限制
主要优势
- 从 OCR、结构化提取、RAG、脱敏到智能体工具集成在同一 .NET 运行时或私有服务中,减少多语言与多服务维护成本。
- 可在无网络、数据驻留或高文档量环境中使用自有硬件推理,不按页数、令牌或席位另行计费。
使用限制
- 本地部署需自行规划模型权重、内存与显存、备份、日志、补丁、访问控制和高可用性,不会因为不上传云端就自动满足合规。
- 较大模型、长上下文、视觉 OCR、并发推理和微调对硬件要求较高,CPU 虽可运行但不代表所有工作负载都有合适速度。
- 输出的信心度、结构约束和页码引用能帮助审核,但不能替代对合同、理赔、财务、人事或法规结果的专业人工核对。
- LM-Kit One 仍在 Business Preview,需要预留接口变更、数据迁移和回退空间,不应把预览版稳定性当作正式 LTS 承诺。
总结
LM-Kit 适合必须将敏感文档、检索索引和模型推理留在自有环境中,同时需要 .NET、RAG、MCP、文档工具和可审计智能体的团队。
上线前应分别审核 LM-Kit 产品许可、GitHub 子项目许可和模型权重许可,并用固定文档集验证精度、吞吐、硬件容量与数据披露边界。
©️版权声明:若无特殊声明,本站所有文章版权均归AI工具分享原创和所有,未经许可,任何个人、媒体、网站、团体不得转载、抄袭或以其他方式复制发表本站内容,或在非我站所属的服务器上建立镜像。否则,我站将依法保留追究相关法律责任的权利。
类似于LM-Kit的工具


AI工具盒导航收录了国内外数百个不同类型的AI工具,每日更新和添加最新AI工具,AI工具盒还推荐了AI学习开发的常用网站、框架和模型,帮助你加入人工智能浪潮,自动化高效完成任务!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。
 桂公网安备45132202000164号